プレビュー
この機能はまだ開発中ですが、ぜひお試しください。
この機能は現在、弊社のプレリリース ポリシーに従ってプレビュー プログラムの一部として提供されています。
最新のKubernetes環境は、複雑なマルチクラスタ フリートに進化しましたが、従来の観察ツールでは、多くの場合、個々のクラスタの分割されたサイロ化されたビューしか提供されません。 この Kubernetes クロスクラスター UI は、このマルチクラスターの複雑さをフリート全体の明確さに変換する統合コマンド センターを提供します。
この統合ビューは、プラットフォーム エンジニアと SRE が次のことを実行するのに役立ちます。
- New RelicエージェントまたはOpenTelemetryによるクラスタモニターと互換性のある単一ダッシュボード上でフリート全体の監視を統合します。
- ガイド付きトリアージ ワークフローを使用して根本原因分析を加速します。
- 艦隊全体で無駄なリソースを特定することでコストを削減します。
- セルフサービスのためのアプリケーション中心のビューで開発者を支援します。
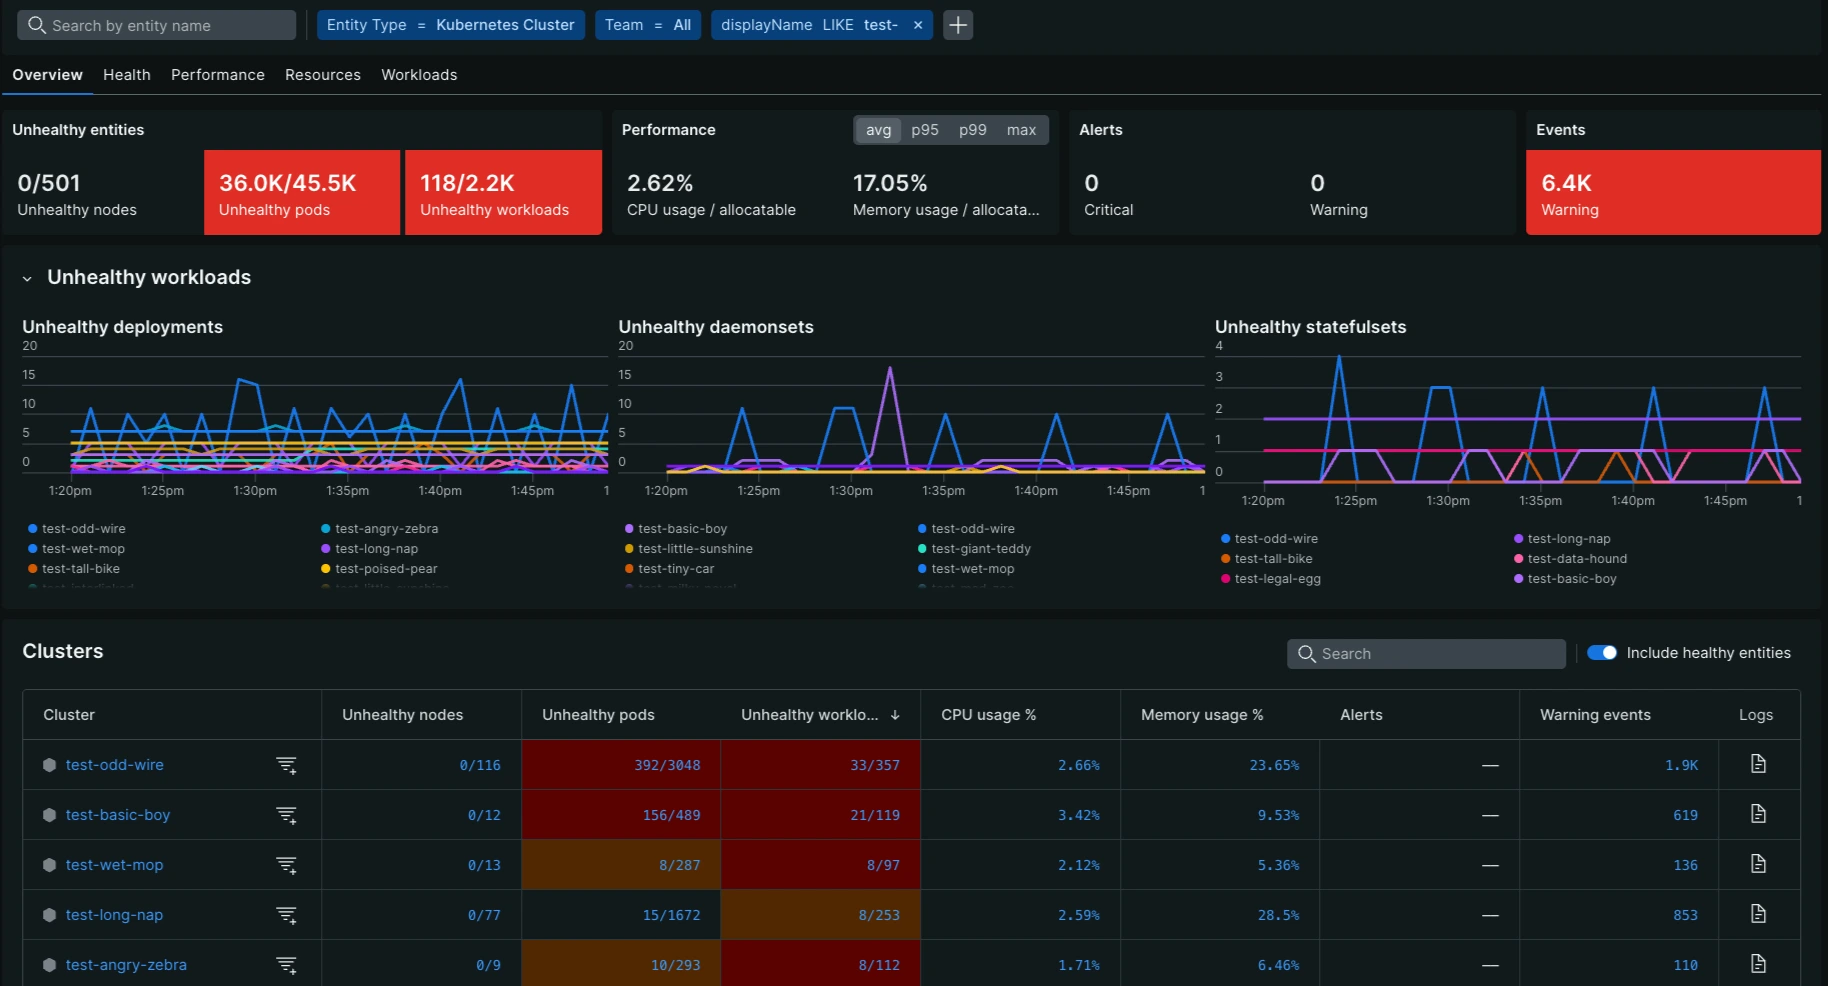
新しいUIにアクセスする
New Relic プラットフォームの左側のナビゲーションにある Kubernetes オプションから、新しい Kubernetes クロスクラスター UI にアクセスできます。
Kubernetes クロスクラスター UI にアクセスするには:
- に行く one.newrelic.com > All capabilities > Kubernetes
- ページの右上隅にあるTry it out [試してみる]ボタンをクリックします。
スコアカードとテーブル
スコアカードはフリート全体の各メトリクスを要約し、内訳テーブルはクラスタ、ノード、またはワークロードごとに値を分類します。値が重大度の閾値に達すると、スコアカードとテーブルの行の両方がオレンジ色(警告)または赤色(クリティカル)に変わります。2/436などの比率は、そのパーセンテージに基づいて色が変わります。
- スコアカードと折れ線グラフを更新するには、
avg、p95、p99、またはmaxを選択します。内訳テーブルには常に平均値が表示されます。 - Include healthy entities[健全なエンティティを含める] を無効にして、アクティブなオレンジ色または赤色のステータス閾値を持つエンティティにリストをフィルタリングします。
- レポートを停止したエンティティはリストに残り、選択した時間範囲の履歴データが表示されます。
トリアージのためのドリルダウン機能
フリート全体のメトリクスから個々のエンティティへと移行するガイド付きトリアージ・ワークフローを使用して、クロス・クラスタUIで根本原因分析を迅速化できます:
- スコアカードからエンティティのランキングへ:スコアカードを選択して、そのメトリクスにより重大度の降順でテーブルを並べ替え、上位10個のエンティティを折れ線グラフにプロットします
- 表のメトリクスからKubernetesナビゲーターへ: メトリクスの値の上にマウスポインターを置いてエンティティのトレンドラインを表示し、View in navigatorを選択してKubernetesナビゲーターを開きます。
- エンティティから詳細へ:エンティティ名にカーソルを合わせてそのゴールデンメトリクスと関連するエンティティを表示するか、クリックして概要ページを開きます。
タブ固有のメトリクス
UIは5つのメイン・タブで構成されています。Scorecard:の閾値はスコアカードに適用され、Table:の閾値は表の行に適用されます。同じ場合は、1つのセットのみが表示されます。カウントは選択した時間範囲を対象とします。
Overview [概要]タブには、Kubernetes フリート全体の運用の健全性、容量、およびリスクの概要が表示されます。
メトリクス名 | 説明 | 重要性 | 閾値 |
|---|
Unhealthy nodes
| すべてのノードのうち、正常ではないノード。ノードが準備できていない場合、またはプレッシャーやネットワークの状態を報告している場合、そのノードは正常ではありません。 | インフラストラクチャ全体にわたる広範囲にわたる不安定性と潜在的なゾーン障害を通知します。 | オレンジ色:ノードの1%~<5%;赤色:≥5%。 |
Unhealthy workloads
| すべてのワークロードのうち、欠落しているか利用できないポッドがあるデプロイメント、デーモンセット、およびステートフルセット。 | 組織全体で望ましい状態を調整できなかったことを示します。 | オレンジ色:ワークロードの1%~<5%;赤色:≥5%。 |
Running pods
| ジョブポッドと完了したポッドを除く、 Running
フェーズにあるポッドの割合(%)。 | 稼働成功率;実行中のポッドが90%未満であることは、広範囲にわたる障害を示しています。 | Scorecard:
オレンジ:90%~<95%;赤:<90%。 Table:
オレンジ:>95%~99%;赤:≤95%。 |
CPU usage
| 割り当て可能なCPUに対するノードのCPU使用率(%)。 | 資産全体のノード飽和リスクを総合的に測定します。 | オレンジ色:75%~<95%;赤色:≥95%。 |
Memory usage
| 割り当て可能なメモリに対するノードのメモリ使用率。 | 値が高い場合は、クラスター全体で集約的なエビクション ストームが発生するリスクがあることを示します。 | オレンジ色:75%~<95%;赤色:≥95%。 |
Ephemeral storage
| ノードのファイルシステム容量の使用率。 | Kubelet のクラッシュを防ぐために重要です。 | オレンジ色:75%~<95%;赤色:≥95%。 |
Persistent storage
| ポッドのボリューム容量の使用率。 | ステートフルアプリケーションのクラッシュやデータ書き込みの失敗を防ぐために不可欠です。 | オレンジ色:75%~<95%;赤色:≥95%。 |
Warning events
| Kubernetesの Warning
イベントの数。 | ノイズレベルが高いと重大なアラートがわかりにくくなり、設定の負債が示されます。 | オレンジ:1~49;赤:≥50。 |
Health [ヘルス]タブは、ノードの可用性と現在のステータスに関連するメトリクスと、差し迫った障害リスクを検出するためのポッドに焦点を当てています。
メトリクス名 | 説明 | 重要性 | 閾値 |
|---|
Nodes ready
| すべてのノードのうち、異常な状態を報告しなかったノード。 | 可用性メトリクス。 95% を下回る値は、フリートが著しく不安定であることを示します。 | Scorecard:
オレンジ色:95%~<100%;赤色:<95%。 Table:
Clusterの行:オレンジ色:準備ができているノードの>1%~2%;赤色:≤1%。ノードの行:赤色: FALSE
。 |
Node memory pressure
| MemoryPressure
を報告しているノードの数。 | 広範囲にわたる立ち退きの嵐を予測します。 | Scorecard:
オレンジ色:ノードの1%~<6%;赤色:≥6%。 Table:
Clusterの行:オレンジ色:98ノード;赤色:≥99ノード。ノードの行:赤色: TRUE
。 |
Node disk pressure
| DiskPressure
を報告しているノードの数。 | ディスク枯渇による広範囲にわたるノード障害のリスク。 | Scorecard:
オレンジ色:ノードの1%~<6%;赤色:≥6%。 Table:
Clusterの行:オレンジ色:98ノード;赤色:≥99ノード。ノードの行:赤色: TRUE
。 |
Running pods
| ジョブポッドと完了したポッドを除く、 Running
フェーズにあるポッドの割合(%)。 | 稼働成功率;実行中のポッドが90%未満であることは、広範囲にわたる障害を示しています。 | Scorecard:
オレンジ:90%~<95%;赤:<90%。 Table:
オレンジ:>95%~99%;赤:≤95%。 |
Pending pods
| ジョブ・ポッドを除く、 Pending
フェーズにあるポッドの数。 | スケジューラの障害または容量不足を示します。 | Scorecard:
オレンジ色:1~5;赤色:≥6。 Table:
オレンジ色:1;赤色:≥2。 |
Container restarts
| コンテナの再起動回数。 | CrashLoopBackOff または OOMKills の症状。 | Scorecard:
オレンジ色:1~5;赤色:≥6。 Table:
オレンジ色:1;赤色:≥2。 |
Network errors (per second)
| 1秒あたりのネットワークエラーの発生率。 | ハードウェア障害またはシステム的な CNI の問題の症状。 | Scorecard:
オレンジ色:100ノードあたり11~<50;赤色:100ノードあたり≥50。 Table:
オレンジ色:5~10;赤色:≥11。 |
Warning events
| Kubernetesの Warning
イベントの数。 | ノイズレベルが高いと重大なアラートがわかりにくくなり、設定の負債が示されます。 | オレンジ:1~49;赤:≥50。 |
Performance [パフォーマンス]タブでは、総容量と制限に対する使用率を測定して、ノードの飽和とパフォーマンス低下のリスクを特定します。
メトリクス名 | 説明 | 重要性 | 閾値 |
|---|
CPU usage (total)
| 割り当て可能なCPUに対するノードのCPU使用率(%)。 | 資産全体の飽和リスクを測定します。 | オレンジ色:75%~<95%;赤色:≥95%。 |
CPU usage (limits)
| 設定されている場合の、CPU制限に対するCPU使用率。 | スロットルへの近さを測定します。 | オレンジ色:75%~<95%;赤色:≥95%。 |
Memory usage (total)
| 割り当て可能なメモリに対するノードのメモリ使用率。 | 立ち退きの近接性値。 | オレンジ色:75%~<95%;赤色:≥95%。 |
Memory usage (limits)
| 設定されている場合、メモリ制限に対するメモリワーキングセットの割合(%)。 | OOMKill イベントへの近さ。 | オレンジ色:75%~<95%;赤色:≥95%。 |
Ephemeral storage
| ノードのファイルシステム容量の使用率。 | Kubelet のクラッシュを防ぐために重要です。 | オレンジ色:75%~<95%;赤色:≥95%。 |
Pod capacity
| ノードが実行できる最大ポッド数に対する、実行中のポッドの割合。 | リソース密度とスロット枯渇を測定します。 | オレンジ:85%~<100%;赤:≥100%。 |
Warning events
| Kubernetesの Warning
イベントの数。 | ノイズレベルが高いと重大なアラートがわかりにくくなり、設定の負債が示されます。 | オレンジ:1~49;赤:≥50。 |
Resources [リソース]タブでは、リクエストと使用量、およびリクエストと制限を分析して、リソース割り当ての効率を評価し、無駄やサイズの不正確さを特定します。
メトリクス名 | 説明 | 重要性 | 閾値 |
|---|
CPU usage vs requests
| CPUのrequestsに対するCPU使用率。 | メトリクスによるサイジングの精度と無駄のガバナンス。 | Scorecard:
オレンジ:<70%または≥200%。 Table:
オレンジ:200%。 |
CPU requests vs limits
| CPU制限に対するCPUのrequestsの割合(%)。 | パフォーマンスのヘッドルームとバースト容量を測定します。 | オレンジ色:75%~<95%;赤色:≥95%。 |
CPU throttling
| コンテナがスロットルされたCPU期間の割合(%)。 | CFS クォータに起因するレイテンシ/ラグを測定します。 | オレンジ色:10%~<50%;赤色:≥50%。 |
Memory usage vs requests
| メモリのrequestsに対するメモリ使用率(%)。 | メモリサイジングの精度を高めるガバナンスメトリクス。 | Scorecard:
オレンジ:<70%または≥200%。 Table:
オレンジ:200%。 |
Memory requests vs limits
| メモリ制限に対するメモリのrequestsの割合。 | リソース割り当ての効率と潜在的なオーバープロビジョニングを評価するのに役立ちます。 | オレンジ色:75%~<95%;赤色:≥95%。 |
Pod evictions
| kubeletによってエビクトされたポッドの数。 | ノード リソース不足の症状。 | Scorecard:
オレンジ色:1~5;赤色:≥6。 Table:
オレンジ色:1;赤色:≥2。 |
Warning events
| Kubernetesの Warning
イベントの数。 | ノイズレベルが高いと重大なアラートがわかりにくくなり、設定の負債が示されます。 | オレンジ:1~49;赤:≥50。 |
Workloads [ワークロード]タブは、アプリケーションの不安定性やQoSの低下を診断するために、レディネス、再起動、レプリカの欠落などのメトリクスに焦点を当てた、デプロイメント、デーモンセット、ステートフルセットのアプリケーション中心のビューを提供します。
メトリクス名 | 説明 | 重要性 | 閾値 |
|---|
CPU usage (requests)
| CPUのrequestsに対するCPU使用率。 | ワークロードが要求されたCPUの超過にどれだけ近づいているかを測定します。 | オレンジ色:75%~<95%;赤色:≥95%。 |
CPU throttling
| コンテナがスロットルされたCPU期間の割合(%)。 | CFS クォータに起因するレイテンシ/ラグを測定します。 | オレンジ色:10%~<50%;赤色:≥50%。 |
Memory usage (limits)
| 設定されている場合、メモリ制限に対するメモリワーキングセットの割合(%)。 | OOMKill への近さ。 | オレンジ色:75%~<95%;赤色:≥95%。 |
Pods ready/total
| すべてのポッドのうち、準備ができているポッド。 | ワークロードのすべてのポッドが利用可能かどうかを示します。 | Scorecard:
オレンジ色:<100%。 Table:
オレンジ色:≤99%。 |
Pods unavailable
| 利用できない希望するレプリカです。 | サービスの可用性を示します。 | Scorecard:
オレンジ色:1~5;赤色:≥6。 Table:
オレンジ色:1;赤色:≥2。 |
Pods missing
| 必要なレプリカと準備ができているレプリカの間のギャップ。 | サービスの低下を示します。 | Scorecard:
オレンジ色:1~5;赤色:≥6。 Table:
オレンジ色:1;赤色:≥2。 |
Pod evictions
| エビクトされたポッドの数。 | ワークロードがノードプレッシャーを引き起こしているか、誤って構成されています。 | Scorecard:
オレンジ色:1~5;赤色:≥6。 Table:
オレンジ色:1;赤色:≥2。 |
Container restarts
| コンテナの再起動回数。 | 永続的な障害状態 (CrashLoopBackOff)。 | Scorecard:
オレンジ色:1~5;赤色:≥6。 Table:
オレンジ色:1;赤色:≥2。 |
Container image restarts
| 再起動を伴う個別のコンテナイメージの数。 | 再起動が1つのイメージに限定されているか、複数のイメージに分散しているかを示します。 | Scorecard:
オレンジ色:1~2;赤色:≥3。 Table:
オレンジ色:1;赤色:≥2。 |
Warning events
| Kubernetesの Warning
イベントの数。 | ノイズレベルが高いと重大なアラートがわかりにくくなり、設定の負債が示されます。 | オレンジ:1~49;赤:≥50。 |