시사 이 기능은 아직 개발 중이지만 꼭 사용해 보시기 바랍니다!
이 기능은 현재 출시 전 정책 에 따라 미리보기 프로그램의 일부로 제공됩니다.
최신 Kubernetes 환경은 복잡한 다중 클러스터 플릿 으로 발전했지만 기존의 옵저버빌리티 도구는 개별 클러스터에 대해 분리되고 사일로화된 보기만 제공하는 경우가 많습니다. 이 Kubernetes 크로스 클러스터 UI는 다중 클러스터의 복잡성을 전체 클러스터에 걸쳐 명확하게 파악할 수 있도록 통합된 명령 센터를 제공합니다.
이러한 통합된 관점은 플랫폼 엔지니어와 SRE에게 다음과 같은 도움을 줍니다.
뉴렐릭 에이전트 또는 OpenTelemetry 통해 클러스터 모니터와 호환되는 단일 대시보드에 전체 옵저버빌리티를 통합합니다 . 가이드형 분류를 통해 근본 원인 분석을 가속화하세요 . 전체 항공기단에서 낭비되는 자원을 파악하여 비용을 절감하십시오 . 개발자에게 애플리케이션 중심적인 관점을 제공하여 셀프 서비스를 지원합니다 .새로운 UI에 접속하세요 뉴렐릭 플랫폼의 왼쪽 탐색에 있는 Kubernetes 옵션에서 새로운 Kubernetes 크로스 클러스터 UI 액세스할 수 있습니다.
Kubernetes 클러스터 간 UI에 액세스하려면 다음 단계를 따르세요.
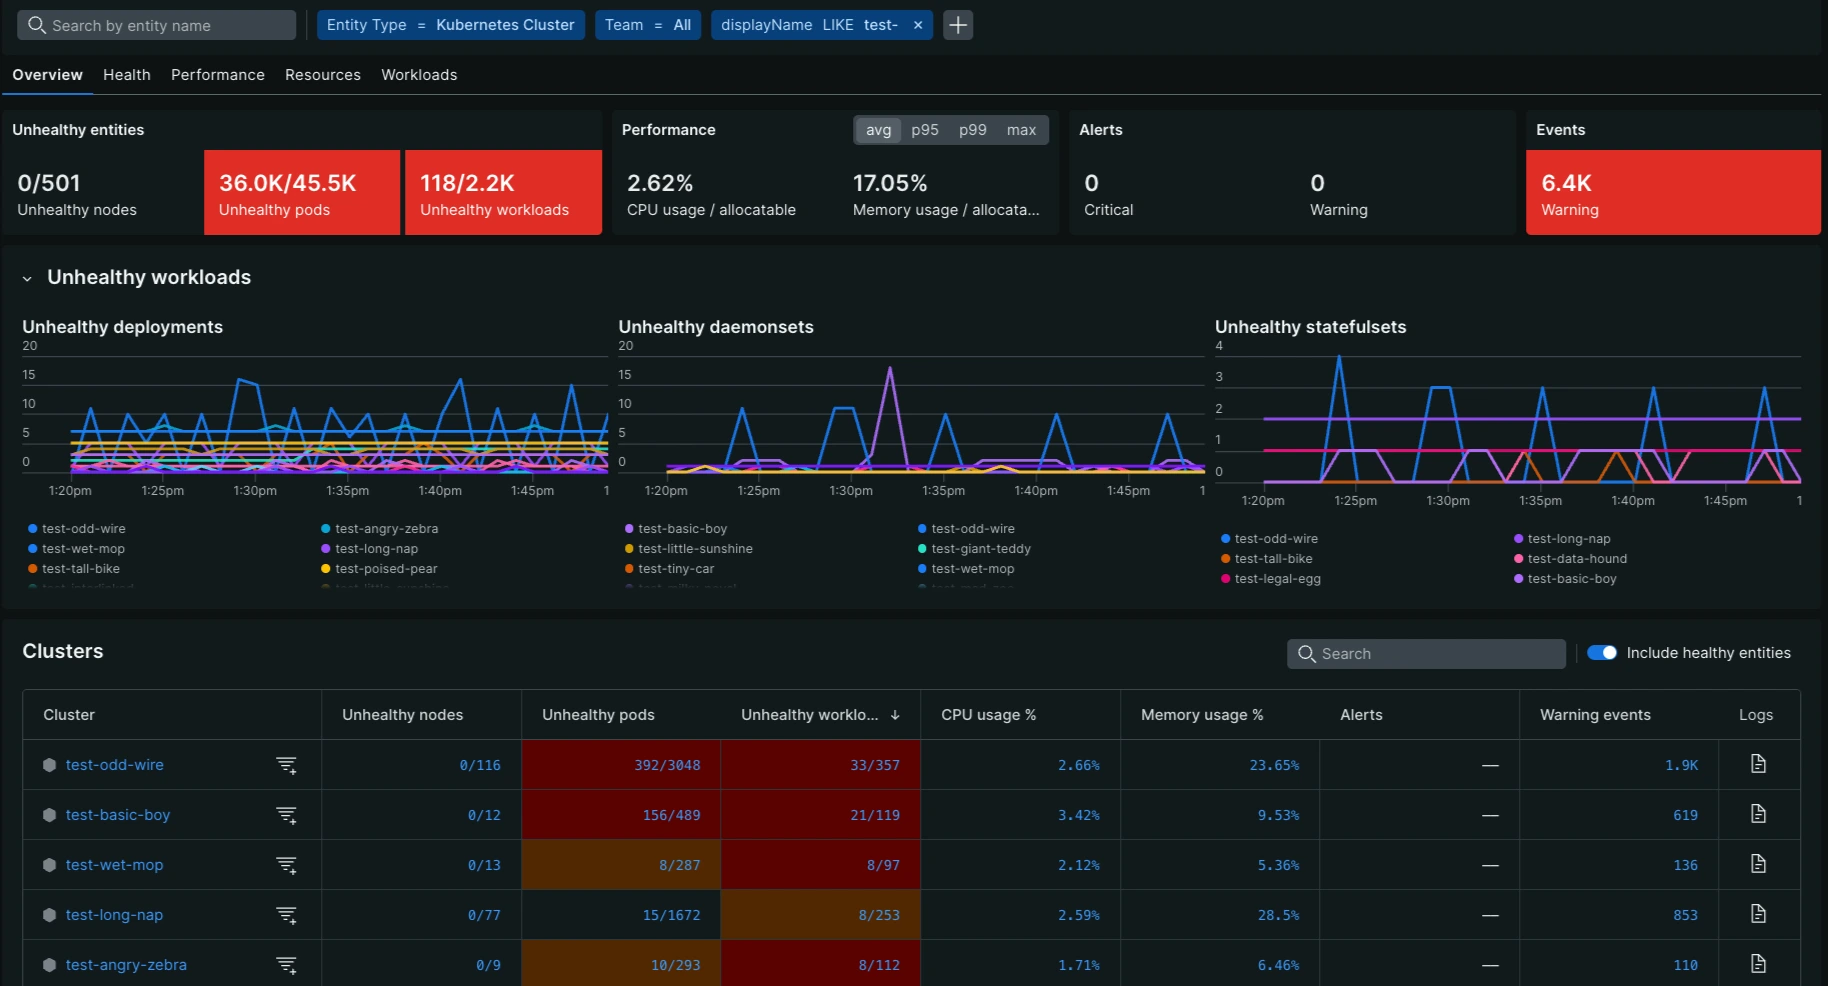
이동 one.newrelic.com > All capabilities > Kubernetes 페이지 오른쪽 상단에 있는 Try it out [직접 사용해 보기] 버튼을 클릭하세요. 스코어카드 및 테이블 스코어카드는 전체 플릿의 각 메트릭을 요약하며, 분류 테이블은 클러스터, 노드 또는 워크로드별로 값을 분류합니다. 값이 심각도 임계값 을 충족하면 스코어카드와 테이블 행이 모두 주황색(경고) 또는 빨간색(위험)으로 바뀝니다. 2/436과(와) 같은 비율은 백분율에 따라 색상이 변경됩니다.
스코어카드와 꺾은선형 차트를 업데이트하려면 avgp95p99max Include healthy entities [정상 엔티티 포함]을 비활성화하여 활성 주황색 또는 빨간색 상태 임계값이 있는 엔티티로 목록을 필터링하십시오.보고를 중단한 엔티티는 목록에 유지되며, 선택한 시간 범위에 대한 이력 데이터를 표시합니다. 환자 분류를 위한 상세 분석 기능 전체 플릿 메트릭에서 개별 엔티티로 이동하는 안내식 심사 워크플로우를 사용하여 교차 클러스터 UI를 통해 근본 원인 분석을 가속화할 수 있습니다:
스코어카드에서 엔티티 순위로: 스코어카드를 선택하여 해당 메트릭을 기준으로 테이블을 심각도 내림차순으로 정렬하고 꺾은선형 차트에 상위 10개 엔티티를 표시하십시오.테이블 메트릭에서 Kubernetes 내비게이터로: 메트릭 값 위로 마우스 포인터를 올려 엔티티 추세선을 표시한 다음, View in navigator 을(를) 선택하여 Kubernetes 내비게이터 를 여십시오.엔티티에서 세부 정보로: 엔티티 이름 위에 마우스를 올려 골든 메트릭 및 관련 엔티티를 확인하거나, 클릭하여 개요 페이지를 여십시오.탭별 지표 UI는 5개의 기본 탭으로 구성됩니다. Scorecard: 임계값은 스코어카드에 적용되고 Table: 임계값은 테이블 행에 적용됩니다. 동일한 경우 한 세트만 나열됩니다. 개수는 선택한 시간 범위를 포함합니다.
개요 탭 Overview [개요] 탭에서는 전체 Kubernetes 환경의 운영 상태, 용량 및 위험 에 대한 일반적인 요약을 제공합니다.
측정항목 이름
설명
중요성
임계값
Unhealthy nodes
전체 노드 중 비정상 노드입니다. 노드가 준비되지 않았거나 압력 또는 네트워크 상태를 보고하는 경우 비정상입니다.
인프라 전반에 걸쳐 광범위한 불안정성과 잠재적인 구역 붕괴 가능성을 시사합니다.
주황색: 노드의 1%~5% 미만, 빨간색: ≥5%.
Unhealthy workloads
전체 워크로드 중 누락되거나 사용할 수 없는 파드가 있는 배포, 데몬셋 및 스테이트풀셋.
조직 전체에 걸쳐 원하는 상태를 조화시키지 못했음을 나타냅니다.
주황색: 워크로드의 1%~<5%, 빨간색: ≥5%.
Running pods
잡 파드 및 완료된 파드를 제외한, Running 단계에 있는 파드의 백분율입니다.
운영 성공률이며, 실행 중인 파드가 90% 미만인 경우 광범위한 장애를 나타냅니다.
Scorecard: 주황색: 90%~95% 미만; 빨간색: 90% 미만. Table: 주황색: 95% 초과~99%; 빨간색: 95% 이하.
CPU usage
할당 가능한 CPU의 백분율로 나타낸 노드 CPU 사용량입니다.
전체 시스템에 걸쳐 노드 포화 위험을 집계합니다.
주황색: 75%~95% 미만; 빨간색: 95% 이상.
Memory usage
할당 가능한 메모리 대비 노드 메모리 사용량의 백분율입니다.
높은 수치는 도시 전역에 걸쳐 집단적인 강제 퇴거 사태의 위험이 있음을 나타냅니다.
주황색: 75%~95% 미만; 빨간색: 95% 이상.
Ephemeral storage
사용된 노드 파일 시스템 용량의 백분율.
Kubelet 충돌을 방지하는 데 매우 중요합니다.
주황색: 75%~95% 미만; 빨간색: 95% 이상.
Persistent storage
사용된 파드 볼륨 용량의 백분율입니다.
상태 저장 애플리케이션의 충돌 및 데이터 쓰기 오류를 방지하는 데 매우 중요합니다.
주황색: 75%~95% 미만; 빨간색: 95% 이상.
Warning events
Kubernetes Warning 이벤트 수입니다.
높은 소음 수준으로 인해 중요 알림이 모호해지고 구성 부채가 표시됩니다.
주황색: 1~49, 빨간색: ≥50.
건강 탭 Health [상태] 탭은 노드의 가용성 및 현재 상태 와 관련된 정보를 중점적으로 다루며, 즉각적인 장애 위험을 감지하는 데 도움을 줍니다.
측정항목 이름
설명
중요성
임계값
Nodes ready
전체 노드 중 비정상 상태를 보고하지 않은 노드입니다.
가용성; 95% 미만의 값은 심각한 함대 불안정성을 나타냅니다.
Scorecard: 주황색: 95%~100% 미만, 빨간색: 95% 미만. Table: Cluster 행: 주황색: 준비된 노드의 >1%~2%, 빨간색: ≤1%. 노드 행: 빨간색: FALSE.
Node memory pressure
MemoryPressure을(를) 보고하는 노드 수입니다.
대규모 강제 퇴거 사태가 발생할 것으로 예측됩니다.
Scorecard: 주황색: 노드의 1%~6% 미만; 빨간색: 6% 이상. Table: Cluster 행: 주황색: 98개 노드; 빨간색: 99개 노드 이상. 노드 행: 빨간색: TRUE.
Node disk pressure
DiskPressure을(를) 보고하는 노드 수입니다.
디스크 용량 부족으로 인한 광범위한 노드 장애 위험.
Scorecard: 주황색: 노드의 1%~6% 미만; 빨간색: 6% 이상. Table: Cluster 행: 주황색: 98개 노드; 빨간색: 99개 노드 이상. 노드 행: 빨간색: TRUE.
Running pods
잡 파드 및 완료된 파드를 제외한, Running 단계에 있는 파드의 백분율입니다.
운영 성공률이며, 실행 중인 파드가 90% 미만인 경우 광범위한 장애를 나타냅니다.
Scorecard: 주황색: 90%~95% 미만; 빨간색: 90% 미만. Table: 주황색: 95% 초과~99%; 빨간색: 95% 이하.
Pending pods
잡 파드를 제외한, Pending 단계에 있는 파드의 수입니다.
스케줄러 오류 또는 용량 부족을 나타냅니다.
Scorecard: 주황색: 1~5; 빨간색: ≥ 6. Table: 주황색: 1; 빨간색: ≥ 2.
Container restarts
컨테이너 재시작 횟수.
CrashLoopBackOff 또는 OOMKills 오류의 증상입니다.
Scorecard: 주황색: 1~5; 빨간색: ≥ 6. Table: 주황색: 1; 빨간색: ≥ 2.
Network errors (per second)
초당 네트워크 오류 발생률.
하드웨어 오류 또는 시스템적인 CNI 문제의 증상입니다.
Scorecard: 주황색: 100개 노드당 11~50 미만, 빨간색: 100개 노드당 ≥50. Table: 주황색: 5~10, 빨간색: 11 이상.
Warning events
Kubernetes Warning 이벤트 수입니다.
높은 소음 수준으로 인해 중요 알림이 모호해지고 구성 부채가 표시됩니다.
주황색: 1~49, 빨간색: ≥50.
Performance [성능] 탭은 총 용량 및 제한 사항 대비 사용률 을 측정하여 노드 포화 상태 및 성능 저하 위험을 식별합니다.
측정항목 이름
설명
중요성
임계값
CPU usage (total)
할당 가능한 CPU의 백분율로 나타낸 노드 CPU 사용량입니다.
전체 자산에 걸쳐 포화 위험을 측정합니다.
주황색: 75%~95% 미만; 빨간색: 95% 이상.
CPU usage (limits)
설정된 경우, CPU 제한에 대한 CPU 사용량의 백분율입니다.
스로틀링에 대한 근접도를 측정합니다.
주황색: 75%~95% 미만; 빨간색: 95% 이상.
Memory usage (total)
할당 가능한 메모리 대비 노드 메모리 사용량의 백분율입니다.
퇴거 근접성, 키예프.
주황색: 75%~95% 미만; 빨간색: 95% 이상.
Memory usage (limits)
설정된 경우 메모리 제한의 백분율로 나타낸 메모리 워킹 셋입니다.
OOMKill 이벤트와의 근접성.
주황색: 75%~95% 미만; 빨간색: 95% 이상.
Ephemeral storage
사용된 노드 파일 시스템 용량의 백분율.
Kubelet 충돌을 방지하는 데 매우 중요합니다.
주황색: 75%~95% 미만; 빨간색: 95% 이상.
Pod capacity
노드에서 실행할 수 있는 최대 파드 수 대비 실행 중인 파드의 백분율입니다.
리소스 밀도와 슬롯 고갈을 측정합니다.
주황색: 85%~<100%, 빨간색: ≥100%.
Warning events
Kubernetes Warning 이벤트 수입니다.
높은 소음 수준으로 인해 중요 알림이 모호해지고 구성 부채가 표시됩니다.
주황색: 1~49, 빨간색: ≥50.
리소스 탭 Resources [리소스] 탭에서는 요청 대비 사용량 및 요청 대비 제한량을 분석하여 리소스 할당 효율성을 평가하고 낭비 또는 규모 산정 오류를 파악합니다.
측정항목 이름
설명
중요성
임계값
CPU usage vs requests
CPU requests의 백분율로 나타낸 CPU 사용량.
규모 정확도 및 낭비에 대한 거버넌스.
Scorecard: 주황색: <70% 또는 ≥200%. Table: 주황색: <70% 또는 >200%.
CPU requests vs limits
CPU 제한의 백분율로 나타낸 CPU requests입니다.
성능 여유 공간과 순간 최대 출력 용량을 측정합니다.
주황색: 75%~95% 미만; 빨간색: 95% 이상.
CPU throttling
컨테이너가 스로틀링된 CPU 기간의 백분율입니다.
CFS 할당량으로 인한 지연 시간/랙을 측정합니다.
주황색: 10%~50% 미만, 빨간색: ≥50%.
Memory usage vs requests
메모리 requests의 백분율로 나타낸 메모리 사용량.
메모리 크기 조정 정확도에 대한 거버넌스 지표입니다.
Scorecard: 주황색: <70% 또는 ≥200%. Table: 주황색: <70% 또는 >200%.
Memory requests vs limits
메모리 제한의 백분율로 나타낸 메모리 requests입니다.
자원 배분 효율성과 잠재적인 과잉 공급을 평가하는 데 도움이 됩니다.
주황색: 75%~95% 미만; 빨간색: 95% 이상.
Pod evictions
kubelet에 의해 축출된 파드의 수입니다.
노드 리소스 부족 증상.
Scorecard: 주황색: 1~5; 빨간색: ≥ 6. Table: 주황색: 1; 빨간색: ≥ 2.
Warning events
Kubernetes Warning 이벤트 수입니다.
높은 소음 수준으로 인해 중요 알림이 모호해지고 구성 부채가 표시됩니다.
주황색: 1~49, 빨간색: ≥50.
워크로드 탭 Workloads [워크로드] 탭은 배포, 데몬셋 및 스테이트풀셋에 대한 애플리케이션 중심 보기를 제공하며, 준비 상태, 재시작 및 누락된 복제본 과 같은 메트릭에 초점을 맞추어 애플리케이션 불안정성과 열악한 QoS를 진단합니다.
측정항목 이름
설명
중요성
임계값
CPU usage (requests)
CPU requests의 백분율로 나타낸 CPU 사용량.
워크로드가 요청된 CPU를 초과하는 데 얼마나 근접했는지 측정합니다.
주황색: 75%~95% 미만; 빨간색: 95% 이상.
CPU throttling
컨테이너가 스로틀링된 CPU 기간의 백분율입니다.
CFS 할당량으로 인한 지연 시간/랙을 측정합니다.
주황색: 10%~50% 미만, 빨간색: ≥50%.
Memory usage (limits)
설정된 경우 메모리 제한의 백분율로 나타낸 메모리 워킹 셋입니다.
OOMKill과의 근접성.
주황색: 75%~95% 미만; 빨간색: 95% 이상.
Pods ready/total
전체 파드 중 준비된 파드입니다.
워크로드의 모든 파드가 사용 가능한지 여부를 표시합니다.
Scorecard: 주황색: <100%. Table: 주황색: ≤99%.
Pods unavailable
사용할 수 없는 원하는 복제본.
서비스 가용성을 나타냅니다.
Scorecard: 주황색: 1~5; 빨간색: ≥ 6. Table: 주황색: 1; 빨간색: ≥ 2.
Pods missing
원하는 레플리카와 준비된 레플리카 간의 차이.
서비스 품질 저하를 나타냅니다.
Scorecard: 주황색: 1~5; 빨간색: ≥ 6. Table: 주황색: 1; 빨간색: ≥ 2.
Pod evictions
축출된 파드 수입니다.
워크로드가 노드 압박을 유발하거나 잘못 구성되었습니다.
Scorecard: 주황색: 1~5; 빨간색: ≥ 6. Table: 주황색: 1; 빨간색: ≥ 2.
Container restarts
컨테이너 재시작 횟수.
지속적인 오류 상태(CrashLoopBackOff).
Scorecard: 주황색: 1~5; 빨간색: ≥ 6. Table: 주황색: 1; 빨간색: ≥ 2.
Container image restarts
다시 시작된 고유 컨테이너 이미지 수입니다.
재시작이 하나의 이미지에 격리되어 있는지 아니면 여러 이미지에 분산되어 있는지 보여줍니다.
Scorecard: 주황색: 1~2, 빨간색: ≥3. Table: 주황색: 1, 빨간색: ≥2.
Warning events
Kubernetes Warning 이벤트 수입니다.
높은 소음 수준으로 인해 중요 알림이 모호해지고 구성 부채가 표시됩니다.
주황색: 1~49, 빨간색: ≥50.