Ainda estamos trabalhando nesse recurso, mas adoraríamos que você experimentasse!
Atualmente, esse recurso é fornecido como parte de um programa de visualização de acordo com nossas políticas de pré-lançamento.
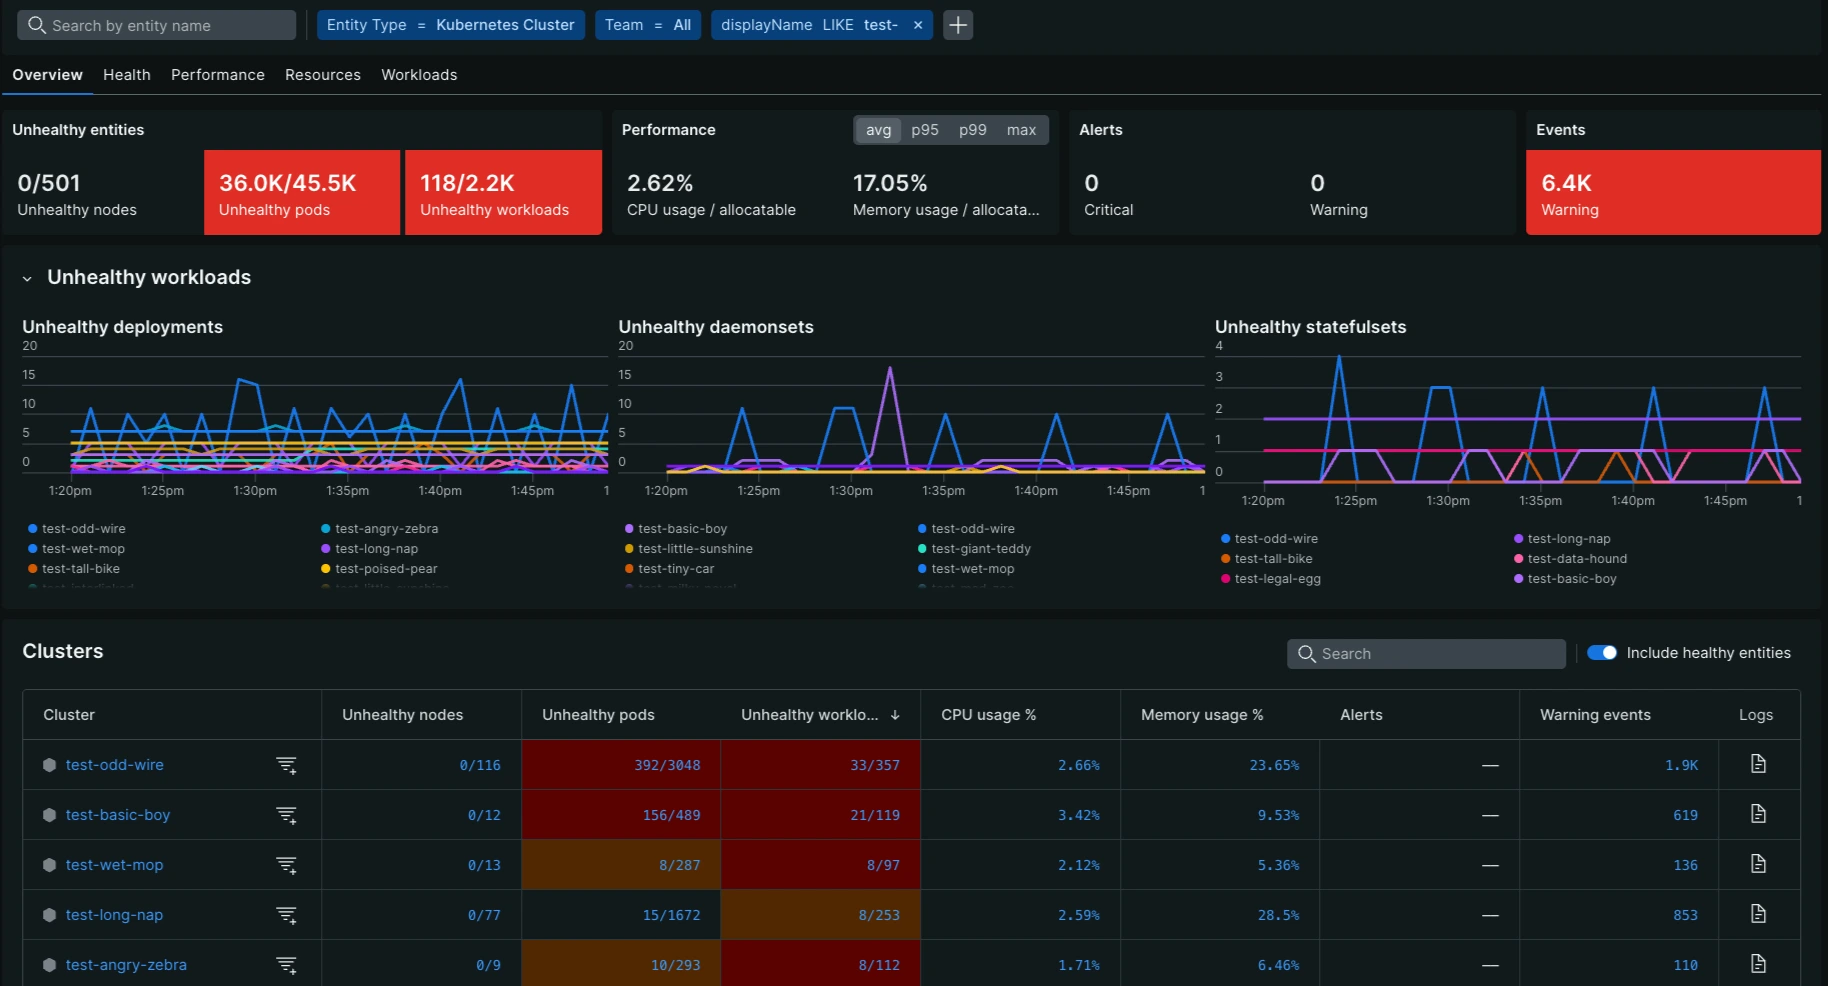
Os ambientes modernos Kubernetes evoluíram para frotas complexas com múltiploscluster , mas as ferramentas tradicionais de observabilidade geralmente fornecem apenas uma visão fragmentada e isolada de cada cluster individual. Essa interface entrecluster Kubernetes fornece um centro de comando unificado que transforma essa complexidade de múltiploscluster em clareza para toda a frota.
Essa visão unificada ajuda a plataforma de engenharia e os engenheiros de confiabilidade de sites (SREs) a:
Unifique a observabilidade de toda a frota em um único dashboard compatível com clusters monitorados pelo agente New Relic ou OpenTelemetry.
Acelere a análise da causa raiz com um fluxo de trabalho de triagem guiado.
Reduza custos identificando recursos desperdiçados em toda a frota.
Capacitar os desenvolvedores com uma visão centrada em aplicativos para o autoatendimento.
Acesse a nova interface do usuário.
Você pode acessar a nova interface entrecluster Kubernetes a partir da opção Kubernetes na navegação à esquerda da plataforma New Relic.
Para acessar a interface entrecluster Kubernetes :
Clique no botão Try it out no canto superior direito da página.
Scorecards e tabela
Os scorecards resumem cada métrica em toda a sua frota, e a tabela de detalhamento categoriza os valores por cluster, nó ou workload. Tanto os scorecards quanto as linhas da tabela mudam para laranja (aviso) ou vermelho (crítico) quando um valor atinge um limite de gravidade. Proporções como 2/436 mudam de cor com base em sua porcentagem.
Selecione avg, p95, p99 ou max para atualizar os scorecards e o gráfico de linhas. A tabela de detalhamento sempre exibe valores médios.
Desative Include healthy entities para filtrar a lista para entidades com um limite de status laranja ou vermelho ativo.
As entidades que pararam de relatar permanecem na lista, exibindo dados históricos para o intervalo de tempo selecionado.
Capacidade de detalhamento para triagem
Você pode acelerar a análise de causa raiz com a interface entre clusters usando um fluxo de trabalho de triagem guiada que vai de métricas de toda a frota até entidades individuais:
Do scorecard à classificação de entidades: selecione um scorecard para classificar a tabela por essa métrica em ordem decrescente de gravidade e plotar as 10 principais entidades no gráfico de linha
Da métrica de tabela para o navegador do Kubernetes: passe o ponteiro do mouse sobre um valor de métrica para exibir a linha de tendência da entidade e, em seguida, selecione View in navigator para abrir o navegador do Kubernetes.
Da entidade aos detalhes: passe o mouse sobre o nome de uma entidade para ver suas métricas clássicas e entidades relacionadas, ou clique nele para abrir sua página de visão geral.
Métrica específica da guia
A interface é organizada em cinco abas principais. Os limites Scorecard: se aplicam aos scorecards e os limites Table: se aplicam às linhas da tabela. Quando são iguais, apenas um conjunto é listado. As contagens cobrem o intervalo de tempo selecionado.
A aba Overview fornece um resumo geral da saúde operacional, capacidade e risco em toda a sua frota Kubernetes.
Nome da métrica
Descrição
Importância
Limites
Unhealthy nodes
Nós não íntegros de todos os nós. Um nó não é íntegro se não estiver pronto ou relatar uma condição de pressão ou de rede.
Sinaliza instabilidade generalizada e possíveis falhas em zonas da infraestrutura.
Laranja: 1% a < 5% dos nós; vermelho: ≥ 5%.
Unhealthy workloads
Implantações, daemonsets e statefulsets com pods ausentes ou indisponíveis, de todos os workloads.
Indica uma falha em conciliar os estados desejados em toda a organização.
Laranja: 1% a < 5% dos workloads; vermelho: ≥ 5%.
Running pods
Porcentagem de pods na fase
Running
, excluindo pods de job e pods concluídos.
Taxa de sucesso operacional; menos de 90% de pods em execução indica falha generalizada.
Scorecard:
Laranja: 90% a < 95%; vermelho: < 90%.
Table:
Laranja: > 95% a 99%; vermelho: ≤ 95%.
CPU usage
Uso de CPU do nó como uma porcentagem da CPU alocável.
Mede o risco agregado de saturação de nós em toda a rede.
Laranja: 75% a < 95%; vermelho: ≥ 95%.
Memory usage
Uso de memória do nó como porcentagem da memória alocável.
Valores elevados indicam risco de ondas de despejo em todo o aglomerado.
Laranja: 75% a < 95%; vermelho: ≥ 95%.
Ephemeral storage
Porcentagem da capacidade do sistema de arquivos do nó usada.
Fundamental para evitar falhas do Kubelet.
Laranja: 75% a < 95%; vermelho: ≥ 95%.
Persistent storage
Porcentagem da capacidade de volume do pod usada.
Crítico para evitar falhas em aplicações stateful e falhas de gravação de dados.
Laranja: 75% a < 95%; vermelho: ≥ 95%.
Warning events
Número de eventos
Warning
do Kubernetes.
Altos níveis de ruído obscurecem o alerta crítico e indicam dívida de configuração.
Laranja: 1 a 49; vermelho: ≥ 50.
A aba Health concentra-se em métricas relacionadas à disponibilidade e ao estado atual de seus nós e pods para detectar riscos de falha imediatos.
Nome da métrica
Descrição
Importância
Limites
Nodes ready
Nós que não relataram nenhuma condição não íntegra, de todos os nós.
Métrica de disponibilidade; valores abaixo de 95% indicam grave instabilidade da frota.
Scorecard:
Laranja: 95% a < 100%; vermelho: < 95%.
Table:
Linhas do Cluster: laranja: > 1% a 2% dos nós prontos; vermelho: ≤ 1%. Linhas do nó: vermelho:
FALSE
.
Node memory pressure
Número de nós relatando
MemoryPressure
.
Prevê ondas de despejos em larga escala.
Scorecard:
Laranja: 1% a < 6% dos nós; vermelho: ≥ 6%. Linhas do Cluster
Taxa de sucesso operacional; menos de 90% de pods em execução indica falha generalizada.
Scorecard:
Laranja: 90% a < 95%; vermelho: < 90%.
Table:
Laranja: > 95% a 99%; vermelho: ≤ 95%.
Pending pods
Número de pods na fase
Pending
, excluindo pods de job.
Indica falha no agendador ou falta de capacidade.
Scorecard:
Laranja: 1 a 5; vermelho: ≥ 6.
Table:
Laranja: 1; vermelho: ≥ 2.
Container restarts
Número de reinicializações do contêiner.
Sintoma de CrashLoopBackOff ou OOMKills.
Scorecard:
Laranja: 1 a 5; vermelho: ≥ 6.
Table:
Laranja: 1; vermelho: ≥ 2.
Network errors (per second)
Taxa de erros de rede por segundo.
Sintoma de falha de hardware ou problemas sistêmicos de CNI.
Scorecard:
Laranja: 11 a < 50 por 100 nós; vermelho: ≥ 50 por 100 nós.
Table:
Laranja: 5 a 10; vermelho: ≥ 11.
Warning events
Número de eventos
Warning
do Kubernetes.
Altos níveis de ruído obscurecem o alerta crítico e indicam dívida de configuração.
Laranja: 1 a 49; vermelho: ≥ 50.
A aba Performance mede a utilização em relação à capacidade total e aos limites para identificar a saturação dos nós e o risco de degradação do desempenho.
Nome da métrica
Descrição
Importância
Limites
CPU usage (total)
Uso de CPU do nó como uma porcentagem da CPU alocável.
Mede o risco de saturação em toda a propriedade.
Laranja: 75% a < 95%; vermelho: ≥ 95%.
CPU usage (limits)
Uso de CPU como uma porcentagem dos limites de CPU, quando definidos.
Mede a proximidade da limitação de desempenho.
Laranja: 75% a < 95%; vermelho: ≥ 95%.
Memory usage (total)
Uso de memória do nó como porcentagem da memória alocável.
Proximidade ao limite de despejo.
Laranja: 75% a < 95%; vermelho: ≥ 95%.
Memory usage (limits)
Conjunto de trabalho de memória como uma porcentagem dos limites de memória, quando definidos.
Proximidade ao evento OOMKill.
Laranja: 75% a < 95%; vermelho: ≥ 95%.
Ephemeral storage
Porcentagem da capacidade do sistema de arquivos do nó usada.
Fundamental para evitar falhas do Kubelet.
Laranja: 75% a < 95%; vermelho: ≥ 95%.
Pod capacity
Pods em execução como porcentagem do máximo de pods que os nós podem executar.
Mede a densidade de recursos e o esgotamento de slots.
Laranja: 85% a < 100%; vermelho: ≥ 100%.
Warning events
Número de eventos
Warning
do Kubernetes.
Altos níveis de ruído obscurecem o alerta crítico e indicam dívida de configuração.
Laranja: 1 a 49; vermelho: ≥ 50.
A aba Resources analisa a relação entre Solicitações e Uso, bem como entre Solicitações e Limites, para avaliar a eficiência da alocação de recursos e identificar desperdícios ou imprecisões de dimensionamento.
Nome da métrica
Descrição
Importância
Limites
CPU usage vs requests
Uso de CPU como uma porcentagem de requests de CPU.
Métrica de governança para dimensionamento, precisão e desperdício.
Scorecard:
Laranja: < 70% ou ≥ 200%.
Table:
Laranja: < 70% ou > 200%.
CPU requests vs limits
Requests de CPU como uma porcentagem dos limites de CPU.
Mede a margem de desempenho e a capacidade de pico.
Laranja: 75% a < 95%; vermelho: ≥ 95%.
CPU throttling
Porcentagem de períodos de CPU em que os contêineres foram limitados.
Mede a latência/atraso causado pelas quotas do CFS.
Laranja: 10% a < 50%; vermelho: ≥ 50%.
Memory usage vs requests
Uso de memória como uma porcentagem de requests de memória.
Métrica de governança para precisão de dimensionamento de memória.
Scorecard:
Laranja: < 70% ou ≥ 200%.
Table:
Laranja: < 70% ou > 200%.
Memory requests vs limits
Requests de memória como porcentagem dos limites de memória.
Auxilia na avaliação da eficiência da alocação de recursos e no potencial de sobrealocação.
Laranja: 75% a < 95%; vermelho: ≥ 95%.
Pod evictions
Número de pods removidos pelo kubelet.
Sintoma de escassez de recursos do nó.
Scorecard:
Laranja: 1 a 5; vermelho: ≥ 6.
Table:
Laranja: 1; vermelho: ≥ 2.
Warning events
Número de eventos
Warning
do Kubernetes.
Altos níveis de ruído obscurecem o alerta crítico e indicam dívida de configuração.
Laranja: 1 a 49; vermelho: ≥ 50.
A aba Workloads fornece uma visão centrada no aplicativo de suas implantações, daemonsets e statefulsets, com foco em métricas como prontidão, reinicializações e réplicas ausentes para diagnosticar instabilidade do aplicativo e baixa qualidade de serviço (QoS).
Nome da métrica
Descrição
Importância
Limites
CPU usage (requests)
Uso de CPU como uma porcentagem de requests de CPU.
Mede o quão perto o workload está de exceder sua CPU solicitada.
Laranja: 75% a < 95%; vermelho: ≥ 95%.
CPU throttling
Porcentagem de períodos de CPU em que os contêineres foram limitados.
Mede a latência/atraso causado pelas quotas do CFS.
Laranja: 10% a < 50%; vermelho: ≥ 50%.
Memory usage (limits)
Conjunto de trabalho de memória como uma porcentagem dos limites de memória, quando definidos.
Proximidade com OOMKill.
Laranja: 75% a < 95%; vermelho: ≥ 95%.
Pods ready/total
Pod prontos de todos os pod.
Mostra se todos os pods do workload estão disponíveis.
Scorecard:
Laranja: < 100%.
Table:
Laranja: ≤ 99%.
Pods unavailable
Réplicas desejadas que não estão disponíveis.
Indica a disponibilidade do serviço.
Scorecard:
Laranja: 1 a 5; vermelho: ≥ 6.
Table:
Laranja: 1; vermelho: ≥ 2.
Pods missing
Diferença entre as réplicas desejadas e prontas.
Indica degradação do serviço.
Scorecard:
Laranja: 1 a 5; vermelho: ≥ 6.
Table:
Laranja: 1; vermelho: ≥ 2.
Pod evictions
Número de pods desalojados.
O workload está causando pressão no nó ou está configurado incorretamente.
Scorecard:
Laranja: 1 a 5; vermelho: ≥ 6.
Table:
Laranja: 1; vermelho: ≥ 2.
Container restarts
Número de reinicializações do contêiner.
Estado de falha persistente (CrashLoopBackOff).
Scorecard:
Laranja: 1 a 5; vermelho: ≥ 6.
Table:
Laranja: 1; vermelho: ≥ 2.
Container image restarts
Número de imagens de contêiner distintas com reinicializações.
Mostra se as reinicializações estão isoladas em uma imagem ou distribuídas por várias.
Scorecard:
Laranja: 1 a 2; vermelho: ≥ 3.
Table:
Laranja: 1; vermelho: ≥ 2.
Warning events
Número de eventos
Warning
do Kubernetes.
Altos níveis de ruído obscurecem o alerta crítico e indicam dívida de configuração.