Te ofrecemos esta traducción automática para facilitar la lectura.
En caso de que haya discrepancias entre la versión en inglés y la versión traducida, se entiende que prevalece la versión en inglés. Visita esta página para obtener más información.
Todavía estamos trabajando en esta característica, ¡pero nos encantaría que la probaras!
Esta característica se proporciona actualmente como parte de un programa de vista previa de conformidad con nuestras políticas de prelanzamiento.
Los entornos modernos Kubernetes evolucionaron hacia flotas complejas de múltiples clústeres, pero las herramientas de observabilidad tradicionales a menudo brindan solo una vista fragmentada y aislada de cada clúster individual. Esta UI entre clústeres Kubernetes proporciona un centro de comando unificado que transforma esta complejidad de múltiples clústeres en claridad para toda la flota.
Esta vista unificada ayuda a Plataforma Ingeniero y SRE a:
Unifique la observabilidad de toda la flota en un solo dashboard que sea compatible con el clúster monitoreado por el agente New Relic o OpenTelemetry.
Acelere el análisis de causa raíz con un flujo de trabajo de clasificación guiado.
Reduzca costos identificando recursos desperdiciados en toda la flota.
Ofrezca a los desarrolladores una vista centrada en la aplicación para el autoservicio.
Acceda a la nueva UI
Puede acceder a la nueva UI entre clústeres Kubernetes desde la opción Kubernetes en la navegación izquierda en la plataforma New Relic.
Haga clic en el botón Try it out en la esquina superior derecha de la página.
Cuadros de mando y tabla
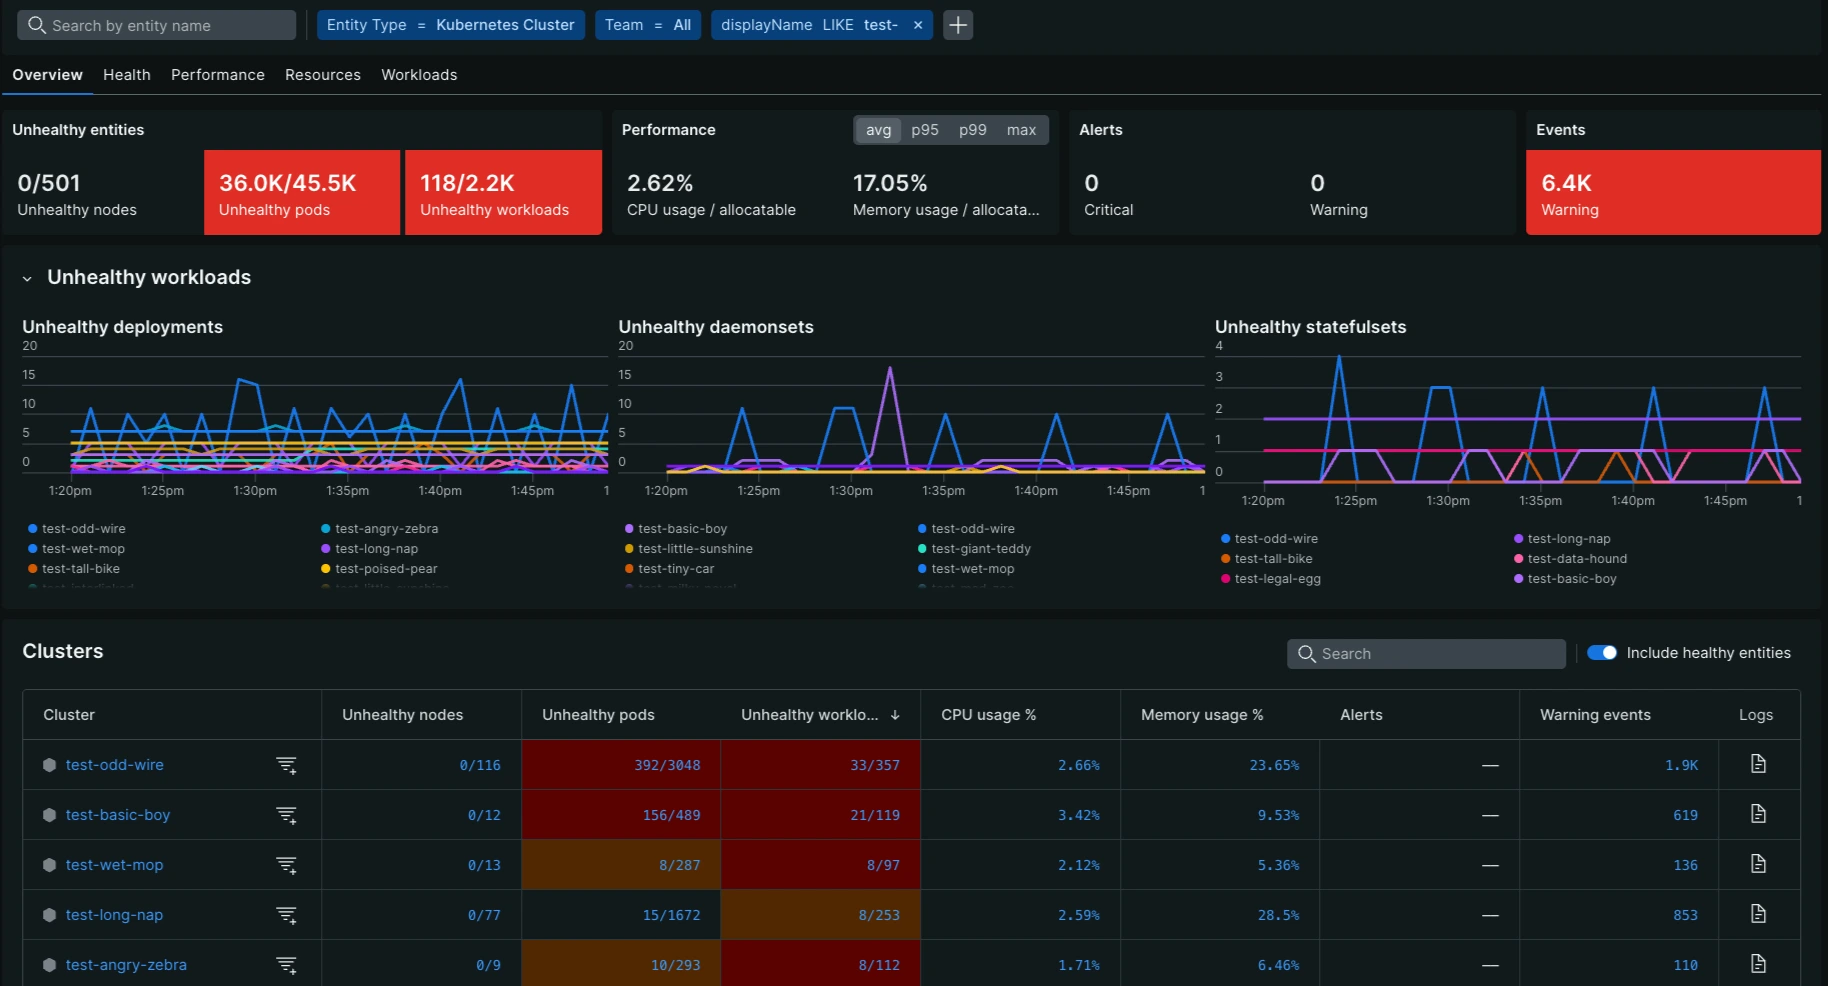
Los cuadros de mando resumen cada métrica en toda la flota, y la tabla de desglose categoriza los valores por clúster, nodo o workload. Tanto los cuadros de mando como las filas de la tabla se vuelven naranjas (advertencia) o rojos (crítico) cuando un valor alcanza un umbral de gravedad. Las proporciones como 2/436 cambian de color según su porcentaje.
Seleccione avg, p95, p99 o max para actualizar los cuadros de mando y el gráfico de líneas. La tabla de desglose siempre muestra los valores promedio.
Desactive Include healthy entities para filtrar la lista a las entidades con un umbral de estado naranja o rojo activo.
Las entidades que han dejado de reportar permanecen en la lista, mostrando datos históricos para el rango de tiempo seleccionado.
Capacidades de desglose para triaje
Puede acelerar el análisis de la causa raíz con la UI entre clústeres mediante un flujo de trabajo de clasificación guiado que va desde la métrica de toda la flota hasta la entidad individual:
De marcador a clasificación de entidades: seleccione un marcador para ordenar la tabla por esa métrica en orden descendente de gravedad y trazar las 10 entidades principales en el gráfico de líneas
De la métrica de la tabla al navegador de Kubernetes: pase el puntero del mouse sobre un valor de métrica para mostrar la línea de tendencia de la entidad, luego seleccione View in navigator para abrir el navegador de Kubernetes.
De la entidad a los detalles: pase el cursor sobre el nombre de una entidad para ver sus métricas doradas y entidades relacionadas, o haga clic en este para abrir su página de resumen.
Métrica específica de la pestaña
La UI está organizada en cinco pestañas principales. Los umbrales Scorecard: se aplican a los cuadros de mando y los umbrales Table: se aplican a las filas de la tabla. Cuando son iguales, solo se muestra un conjunto. Los recuentos cubren el rango de tiempo seleccionado.
La pestaña Overview proporciona un resumen general del estado operativo, la capacidad y el riesgo de toda su flota de Kubernetes.
Nombre de la métrica
Descripción
Importancia
Umbrales
Unhealthy nodes
Nodos en mal estado del total de nodos. Un nodo está en mal estado si no está listo o informa una condición de presión o de red.
Indica una inestabilidad generalizada y posibles fallas en toda la infraestructura.
Naranja: 1 % a <5 % de los nodos; rojo: ≥5 %.
Unhealthy workloads
Despliegues, daemonsets y statefulsets con pods faltantes o no disponibles, de todas las workloads.
Indica un fallo en la conciliación de los estados deseados en toda la organización.
Naranja: 1 % a <5 % de las workloads; rojo: ≥5 %.
Running pods
Porcentaje de pods en la fase
Running
, excluyendo los pods de trabajos y los pods completados.
Tasa de éxito operativo; menos del 90 % de los pods en ejecución indica una falla generalizada.
Scorecard:
Naranja: 90 % a <95 %; rojo: <90 %.
Table:
Naranja: >95 % a 99 %; rojo: ≤95 %.
CPU usage
Uso de CPU del nodo como porcentaje de la CPU asignable.
Mide el riesgo agregado de saturación de nodos en todo el patrimonio.
Naranja: 75 % a <95 %; rojo: ≥95 %.
Memory usage
Uso de memoria del nodo como porcentaje de la memoria asignable.
Los valores altos indican riesgo de tormentas de desalojo agregadas en todo el clúster.
Naranja: 75 % a <95 %; rojo: ≥95 %.
Ephemeral storage
Porcentaje de capacidad del sistema de archivos del nodo utilizada.
Es fundamental evitar fallos en Kubelet.
Naranja: 75 % a <95 %; rojo: ≥95 %.
Persistent storage
Porcentaje de capacidad de volumen del pod utilizada.
Crítico para evitar caídas de aplicaciones con estado y fallas de escritura de datos.
Naranja: 75 % a <95 %; rojo: ≥95 %.
Warning events
Número de eventos
Warning
de Kubernetes.
Los altos niveles de ruido oscurecen la alerta crítica e indican deuda de configuración.
Naranja: 1 a 49; rojo: ≥50.
La pestaña Health se centra en las métricas relacionadas con la disponibilidad y el estado actual de sus nodos y pods para detectar riesgos de fallas inmediatas.
Nombre de la métrica
Descripción
Importancia
Umbrales
Nodes ready
Nodos que no informaron ninguna condición de mal estado, de todos los nodos.
Disponibilidad métrica; valores inferiores al 95% señalan inestabilidad severa de la flota.
Scorecard:
Naranja: 95 % a <100 %; rojo: <95 %.
Table:
filas del Cluster: naranja: >1 % a 2 % de los nodos listos; rojo: ≤1 %. Filas de nodos: rojo:
FALSE
.
Node memory pressure
Número de nodos que informan
MemoryPressure
.
Predice tormentas de desalojos generalizados.
Scorecard:
Naranja: 1 % a <6 % de los nodos; rojo: ≥6 %. Filas de Cluster
, excluyendo los pods de trabajos y los pods completados.
Tasa de éxito operativo; menos del 90 % de los pods en ejecución indica una falla generalizada.
Scorecard:
Naranja: 90 % a <95 %; rojo: <90 %.
Table:
Naranja: >95 % a 99 %; rojo: ≤95 %.
Pending pods
Número de pods en la fase
Pending
, excluyendo los pods de trabajo.
Indica una falla del programador o falta de capacidad.
Scorecard:
Naranja: 1 a 5; rojo: ≥6.
Table:
Naranja: 1; rojo: ≥2.
Container restarts
Número de reinicios del contenedor.
Síntoma de CrashLoopBackOff o OOMKills.
Scorecard:
Naranja: 1 a 5; rojo: ≥6.
Table:
Naranja: 1; rojo: ≥2.
Network errors (per second)
Tasa de errores de red por segundo.
Síntoma de falla de hardware o problemas sistémicos de CNI.
Scorecard:
Naranja: 11 a <50 por cada 100 nodos; rojo: ≥50 por cada 100 nodos.
Table:
Naranja: 5 a 10; rojo: ≥11.
Warning events
Número de eventos
Warning
de Kubernetes.
Los altos niveles de ruido oscurecen la alerta crítica e indican deuda de configuración.
Naranja: 1 a 49; rojo: ≥50.
La pestaña Performance mide la utilización en comparación con la capacidad total y los límites para identificar la saturación del nodo y el riesgo de degradación del rendimiento.
Nombre de la métrica
Descripción
Importancia
Umbrales
CPU usage (total)
Uso de CPU del nodo como porcentaje de la CPU asignable.
Mide el riesgo de saturación en todo el patrimonio.
Naranja: 75 % a <95 %; rojo: ≥95 %.
CPU usage (limits)
Uso de CPU como porcentaje de los límites de CPU, donde estén establecidos.
Mide la proximidad al estrangulamiento.
Naranja: 75 % a <95 %; rojo: ≥95 %.
Memory usage (total)
Uso de memoria del nodo como porcentaje de la memoria asignable.
Proximidad al umbral de desalojo.
Naranja: 75 % a <95 %; rojo: ≥95 %.
Memory usage (limits)
Conjunto de trabajo de memoria como porcentaje de los límites de memoria, donde estén establecidos.
Proximidad al evento OOMKill.
Naranja: 75 % a <95 %; rojo: ≥95 %.
Ephemeral storage
Porcentaje de capacidad del sistema de archivos del nodo utilizada.
Es fundamental evitar fallos en Kubelet.
Naranja: 75 % a <95 %; rojo: ≥95 %.
Pod capacity
Pods en ejecución como porcentaje del máximo de pods que pueden ejecutar los nodos.
Mide la densidad de recursos y el agotamiento de espacios.
Naranja: 85 % a <100 %; rojo: ≥100 %.
Warning events
Número de eventos
Warning
de Kubernetes.
Los altos niveles de ruido oscurecen la alerta crítica e indican deuda de configuración.
Naranja: 1 a 49; rojo: ≥50.
La pestaña Resources analiza Solicitud vs. Uso y Solicitud vs. Límites para evaluar la eficiencia de la asignación de recursos e identificar desperdicios o imprecisiones de tamaño.
Nombre de la métrica
Descripción
Importancia
Umbrales
CPU usage vs requests
Uso de CPU como porcentaje de las requests de CPU.
Gobernanza métrica para dimensionamiento, precisión y desperdicio.
Scorecard:
Naranja: <70 % o ≥200 %.
Table:
Naranja: <70 % o >200 %.
CPU requests vs limits
Requests de CPU como porcentaje de los límites de CPU.
Mide el margen de rendimiento y la capacidad de ráfaga.
Naranja: 75 % a <95 %; rojo: ≥95 %.
CPU throttling
Porcentaje de períodos de CPU en los que se limitaron los contenedores.
Mide la latencia/retraso causado por las cuotas de CFS.
Naranja: 10 % a <50 %; rojo: ≥50 %.
Memory usage vs requests
Uso de memoria como porcentaje de las requests de memoria.
Gobernanza métrica para precisión en el dimensionamiento de la memoria.
Scorecard:
Naranja: <70 % o ≥200 %.
Table:
Naranja: <70 % o >200 %.
Memory requests vs limits
Requests de memoria como porcentaje de los límites de memoria.
Ayuda a evaluar la eficiencia de la asignación de recursos y el potencial exceso de aprovisionamiento.
Naranja: 75 % a <95 %; rojo: ≥95 %.
Pod evictions
Número de pods expulsados por el kubelet.
Síntoma de falta de recursos del nodo.
Scorecard:
Naranja: 1 a 5; rojo: ≥6.
Table:
Naranja: 1; rojo: ≥2.
Warning events
Número de eventos
Warning
de Kubernetes.
Los altos niveles de ruido oscurecen la alerta crítica e indican deuda de configuración.
Naranja: 1 a 49; rojo: ≥50.
La pestaña Workloads proporciona una vista centrada en la aplicación de los despliegues, daemonsets y statefulsets, centrándose en métricas como preparación, reinicios y réplicas faltantes para diagnosticar la inestabilidad de la aplicación y la calidad del servicio deficiente.
Nombre de la métrica
Descripción
Importancia
Umbrales
CPU usage (requests)
Uso de CPU como porcentaje de las requests de CPU.
Mide qué tan cerca está la workload de exceder su CPU solicitada.
Naranja: 75 % a <95 %; rojo: ≥95 %.
CPU throttling
Porcentaje de períodos de CPU en los que se limitaron los contenedores.
Mide la latencia/retraso causado por las cuotas de CFS.
Naranja: 10 % a <50 %; rojo: ≥50 %.
Memory usage (limits)
Conjunto de trabajo de memoria como porcentaje de los límites de memoria, donde estén establecidos.
Proximidad a OOMKill.
Naranja: 75 % a <95 %; rojo: ≥95 %.
Pods ready/total
Pod listos de todos los pod.
Muestra si todos los pods de la workload están disponibles.
Scorecard:
Naranja: <100 %.
Table:
Naranja: ≤99 %.
Pods unavailable
Réplicas deseadas que no están disponibles.
Indica la disponibilidad del servicio.
Scorecard:
Naranja: 1 a 5; rojo: ≥6.
Table:
Naranja: 1; rojo: ≥2.
Pods missing
Diferencia entre las réplicas deseadas y listas.
Indica degradación del servicio.
Scorecard:
Naranja: 1 a 5; rojo: ≥6.
Table:
Naranja: 1; rojo: ≥2.
Pod evictions
Número de pods expulsados.
La workload está causando presión en el nodo o está mal configurada.
Scorecard:
Naranja: 1 a 5; rojo: ≥6.
Table:
Naranja: 1; rojo: ≥2.
Container restarts
Número de reinicios del contenedor.
Estado de falla persistente (CrashLoopBackOff).
Scorecard:
Naranja: 1 a 5; rojo: ≥6.
Table:
Naranja: 1; rojo: ≥2.
Container image restarts
Número de imágenes de contenedor distintas con reinicios.
Muestra si los reinicios están aislados en una imagen o distribuidos en varias.
Scorecard:
Naranja: 1 a 2; rojo: ≥3.
Table:
Naranja: 1; rojo: ≥2.
Warning events
Número de eventos
Warning
de Kubernetes.
Los altos niveles de ruido oscurecen la alerta crítica e indican deuda de configuración.