자신의 데이터 컨텍스트에서 예제 쿼리와 설명을 보면 변화율 및 집계와 같은 고급 개념을 사용하여 데이터를 변환하는 데 도움이 될 수 있습니다. 이 튜토리얼에서는 NRQL 사용의 기초 및 NRQL로 데이터 제어하기에서 다룬 개념을 바탕으로 더 고급 개념을 학습합니다.
케이스별 패싯, 고급 집계 함수, EXTRAPOLATE 키워드, 필터링 집계 함수 및 값 재정의를 사용하여 대시보드를 발전시키는 방법을 배우게 됩니다. 구체적으로 다음을 사용하는 방법을 배우게 됩니다:
filter(),apdex(),rate(),funnel()및histogram()와 같은 고급 집계 함수입니다.EXTRAPOLATE절.FACET CASES()속성 및 그룹 일치 값에 대한 것입니다.filter()이벤트 유형을 결합하기 위한 것입니다.- 값 override.
모든 단일 대시보드에서 이러한 함수와 기능을 사용하지는 않을 수 있지만, 특정 문제와 요구 사항을 해결할 때 유용합니다.
고급 수집기 사용
비율 계산
rate() 함수부터 시작하겠습니다. 시간 경과에 따른 이벤트 빈도를 시각화할 수 있으므로 더 큰 시간 창의 짧은 기간 내에서 패턴을 식별하는 데 도움이 됩니다.
아래 예에서는 이전 시간의 5분 평균 빈도와 비교하여 지난 시간의 5분마다 평균 요청 빈도를 확인할 수 있습니다. 쿼리에서는 SINCE 1 hour ago 사용합니다. 이는 요율을 계산하는 전체 기간입니다.
SELECT rate(count(*), 5 minutes) FROM Public_APICall SINCE 1 hour ago COMPARE WITH 1 hour ago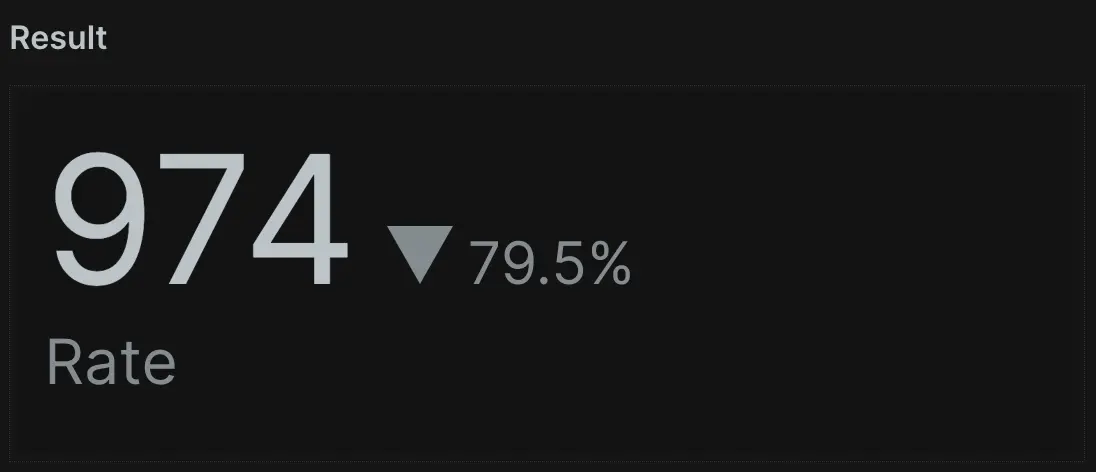
rate() 사용하면 시간 간격을 1분 또는 1초로 설정하여 분당 요청 또는 초당 요청을 계산할 수 있습니다.
유입경로 차트를 통해 최종 사용자 행동 이해
퍼널 차트는 여러 레코드에 걸쳐 속성 값의 발생을 추적하며, 많은 사람들이 최종 사용자 행동을 이해하는 데 이를 사용합니다. 사용자가 정의된 경로를 얼마나 성공적으로 진행하는지 시각화하기 위해, 특히 커스텀 속성을 사용할 때 이를 자주 사용할 수 있습니다.
funnel() 집계자 함수를 사용하여 사용자가 다른 페이지로 이동하기 전에 특정 페이지를 방문하는 사용자 수를 시각화할 수 있습니다. 첫 번째 파라미터는 계산 중인 고유 항목에 대한 식별 속성입니다. 이 경우 뉴렐릭은 사이트의 각 사용자(사용자가 쿠키를 활성화한 경우)에 대해 session ID 속성을 할당하고 유지합니다. 커스텀 속성을 사용하여 자체 세션 ID를 설정할 수도 있습니다.
나머지 매개변수는 유입경로의 각 단계가 계산되는 방식을 결정하며 , WHERE attr OP value 형식으로 작성됩니다. 이 경우 홈페이지를 방문한 사용자 세션 수를 보여주는 하나와 다른 페이지로 이동한 사용자 세션 수를 보여주는 두 가지가 있습니다. 자신의 데이터에 대해 이와 같은 쿼리를 시도하고 결과를 확인하십시오!
SELECT funnel(awsAPI, WHERE http.url LIKE '%.amazonaws.com', WHERE http.url LIKE '%.us-west%.amazonaws.com') FROM Public_APICall SINCE 1 week ago UNTIL now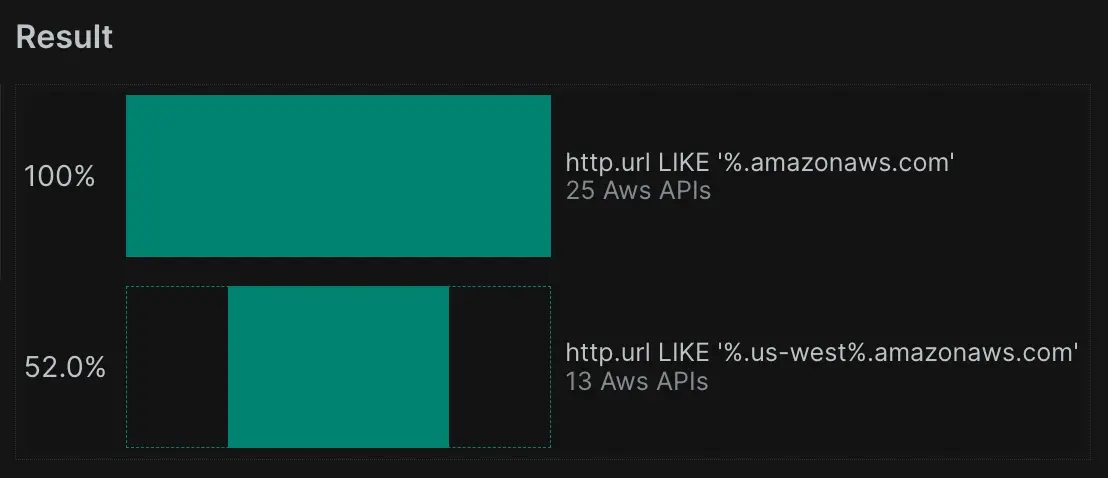
수집기 필터
filter() 단일 쿼리에서 여러 데이터 포인트를 집계할 수 있는 다목적 기능으로, 함수 결과가 반환하는 이벤트를 더 세밀하게 제어할 수 있습니다. 이 예에서는 filter()을(를) 사용하여 총 트랜잭션, 총 웹 트랜잭션 및 총 비 웹 트랜잭션에 대한 개별 값을 반환합니다:
SELECT count(*) AS 'All Transactions', filter(count(*), WHERE awsAPI = 'dynamodb') AS 'DynamoDB', filter(count(*), WHERE awsAPI = 'sqs') AS 'SQS' FROM Public_APICall SINCE 1 day ago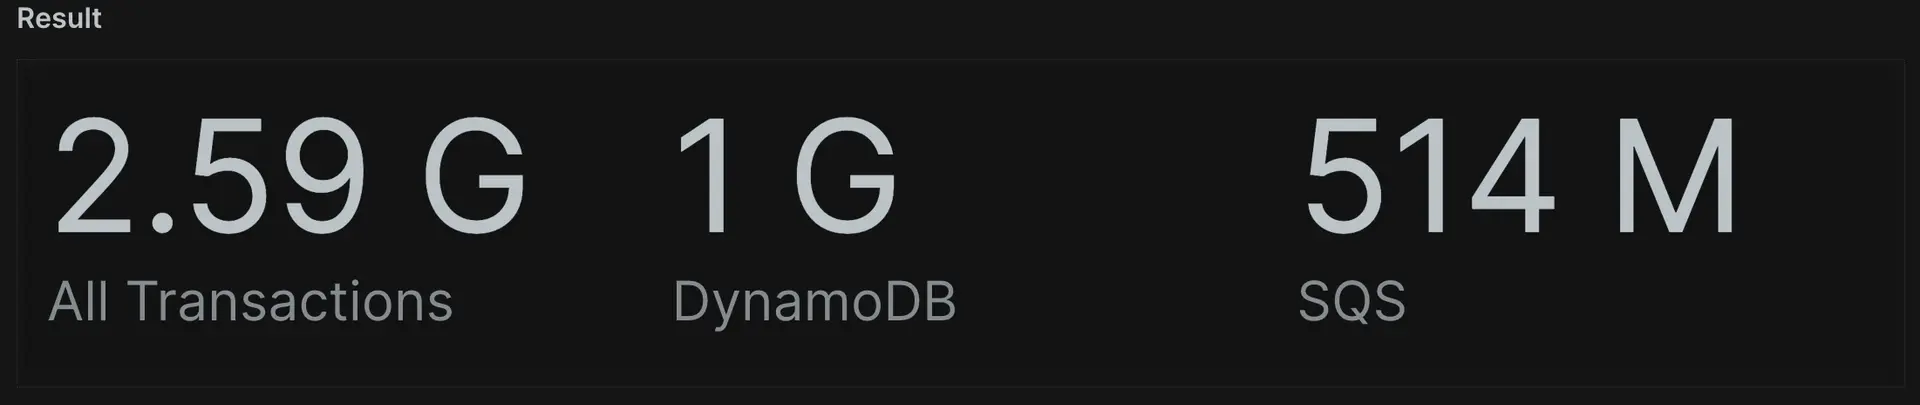
숫자를 반환하므로 쿼리 결과에 대해 계산을 수행할 수도 있습니다. 예를 들어, 총 API 호출을 모든 API 호출로 나누어 그 중 DynamoDB가 몇 퍼센트인지 확인할 수 있습니다.
SELECT filter(count(*), WHERE awsAPI = 'dynamodb') / count(*) AS 'Percent of APIs that are DynamoDB' FROM Public_APICall SINCE 1 day ago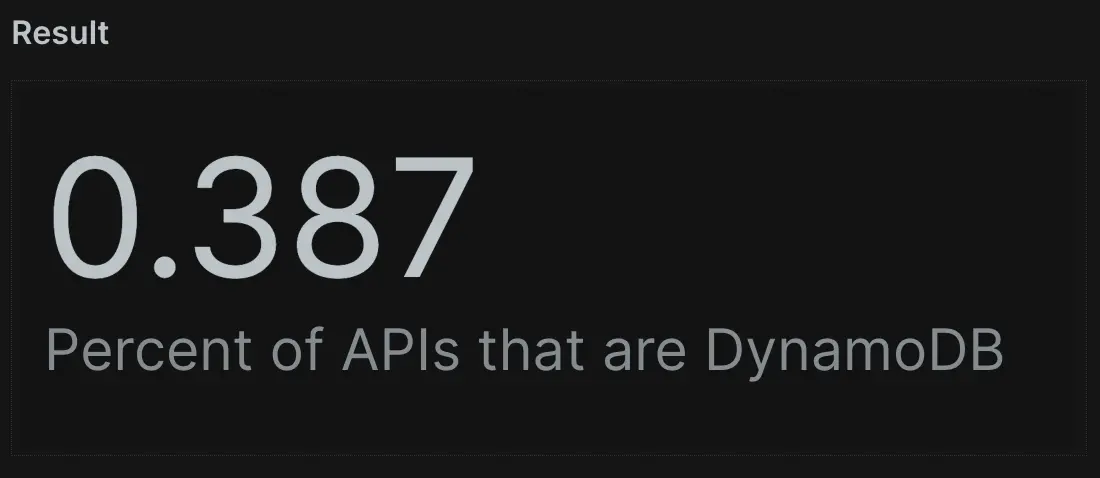
히스토그램
히스토그램은 단일 평균이 아닌 빈도 버킷 전체에 걸친 데이터 분포를 보여줍니다. 이는 단순한 평균이 아니라 빈도별로 데이터 포인트 그룹화를 이해하는 데 도움이 됩니다. histogram() 함수는 세 가지 인수가 필요합니다:
표시하려는 속성(예: 기간)입니다.
고려하려는 범위의 최대값(예: 1초 이하의 경우 "1")입니다.
데이터를 그룹화하려는 버킷 수입니다. 이 예에서는 0-1초 사이의 모든 기간 값에 대한
histogram()차트를 생성하여 50ms 버킷으로 그룹화합니다. 버킷 수를 "20"으로 지정하면 됩니다. 1초보다 큰 모든 지속 시간은 마지막 버킷에 함께 그룹화됩니다.SELECT histogram(duration, 1, 20)FROM Public_APICallSINCE 1 day ago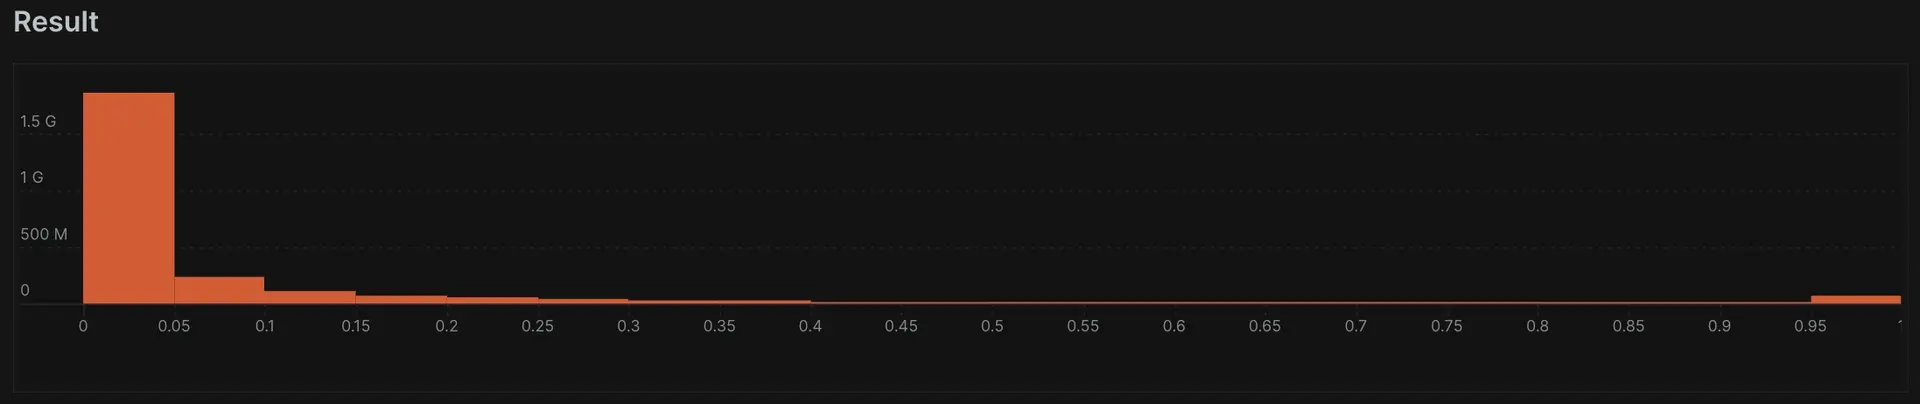
Apdex
apdex() 함수는 숫자 값(예: 기간)에 대한 Apdex 점수를 계산합니다. 사용자 정의 속성 값을 설명하기 위해 하나 이상의 특정 거래에 대해 Apdex를 계산할 수 있습니다. 애플리케이션 설정을 방해하지 않고 자신만의 Apdex-T 값을 제공할 수도 있습니다. 이 예에서는 속성이 "duration"이고 Apdex-T 값이 0.01인 함수를 제공하여 "Apdex of Duration"으로 보고합니다.
SELECT apdex(duration, 0.1) AS 'Apdex Of Duration' FROM Public_APICall SINCE 1 week ago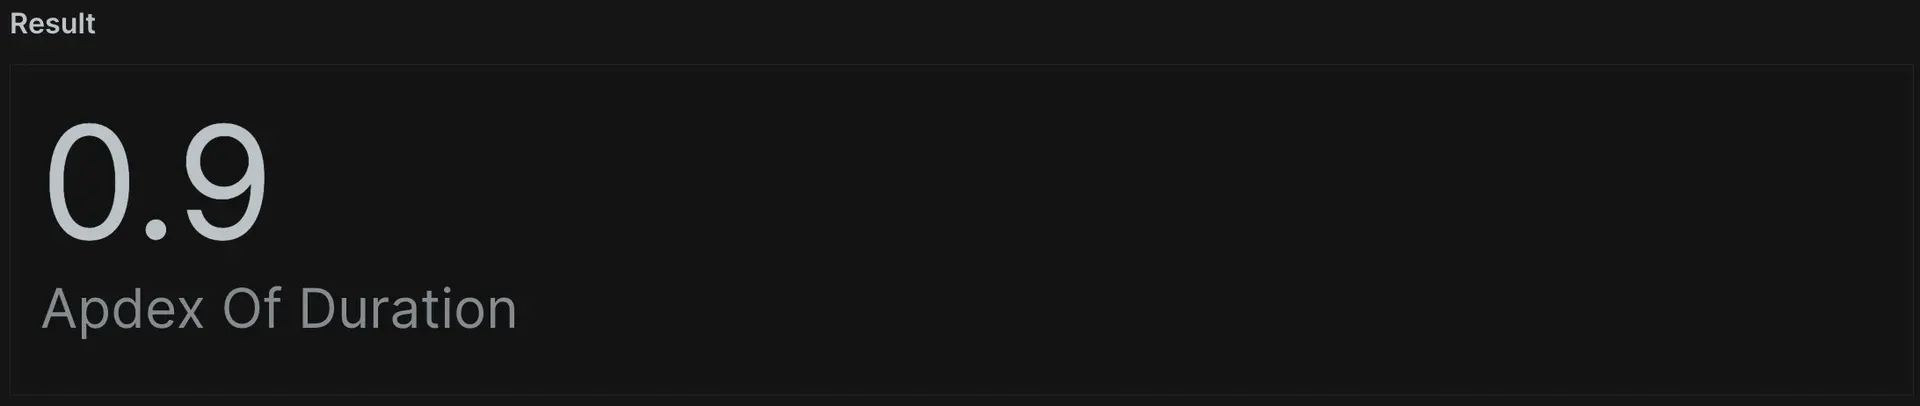
TIMESERIES 연산자를 추가하여 시간 경과에 따른 데이터를 차트로 표시할 수도 있습니다. 이것은 또한 Apdex 만족, 허용 및 불만 임계값을 표시한다는 점에 유의하십시오.
SELECT apdex(duration, 0.1) AS 'Apdex Of Duration' FROM Public_APICall SINCE 1 week ago TIMESERIES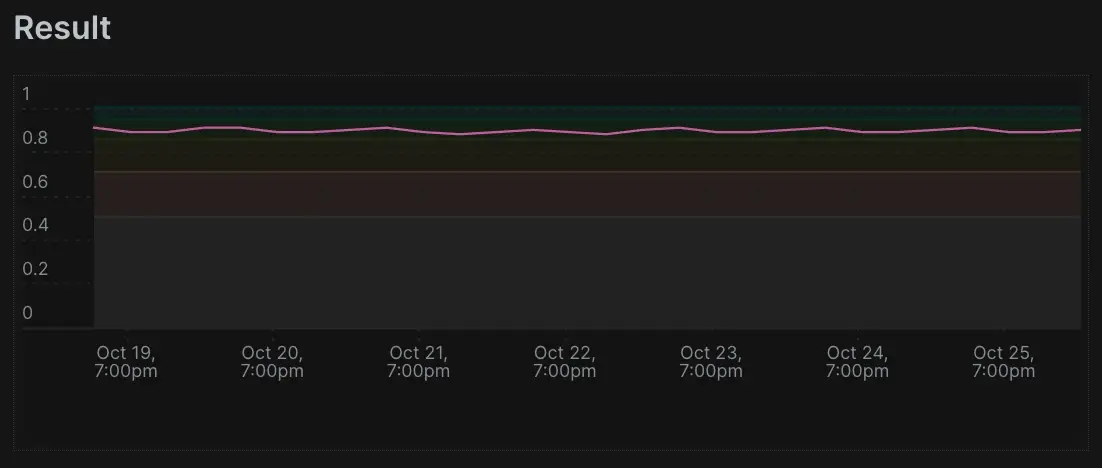
이제 funnel() 및 histogram() 사용하여 완전히 새로운 시각화 세트를 탐색했습니다. 또한 WHERE 절이 포함된 쿼리에서 filter() 어떻게 더 구체적으로 도움이 되는지, 그리고 rate() 시간 경과에 따른 속성 비율을 표시하는 방법을 배웠습니다.
이러한 쿼리는 사용자의 NRQL 지식을 바탕으로 합니다. Apdex는 업계 표준이며 많은 시나리오에 적용됩니다. 퍼널은 원하는 경로를 통한 진행 상황을 추적할 수 있으며, 히스토그램은 데이터의 분포를 시각화합니다. 마지막으로, 필터를 사용하면 반환된 값을 정확하게 좁힐 수 있습니다. 다음으로 EXTRAPOLATE에 대해 알아봅니다.
대량의 데이터에 대해 추정 사용
뉴렐릭 데이터베이스(NRDB)는 매일 대량의 데이터를 수신하고 처리합니다. APM이 대량의 이벤트 데이터를 기록할 때, 뉴렐릭 에이전트는 애플리케이션에 미치는 잠재적인 영향을 줄이면서 의미 있는 데이터를 계속 수집하기 위해 샘플링 기법을 구현합니다. 이는 일반적으로 애플리케이션이나 서비스의 단일 이벤트가 매우 많은 양의 requests를 처리할 때만 발생합니다.
서비스의 여러 로드 밸런싱된 인스턴스에 여러 에이전트가 분산되어 있는 경우 이 제한을 관찰하지 못할 수도 있습니다. 이러한 상황이 발생할 때 수행할 수 있는 작업을 알아보겠습니다. EXTRAPOLATE 연산자는 뉴렐릭에 샘플링 효과를 수학적으로 보정하도록 지시하여 시스템의 활동을 더 가깝게 나타내는 결과를 반환합니다. 제한을 초과하여 발생한 유사한 이벤트 수를 기록하기 위해 추가 값을 저장할 수 있으며, 이를 통해 샘플링되지 않은 데이터를 고려한 추정치를 반환할 수 있습니다.
SELECT count(*) FROM Transaction SINCE 60 minutes ago FACET appName TIMESERIES 1 minute EXTRAPOLATE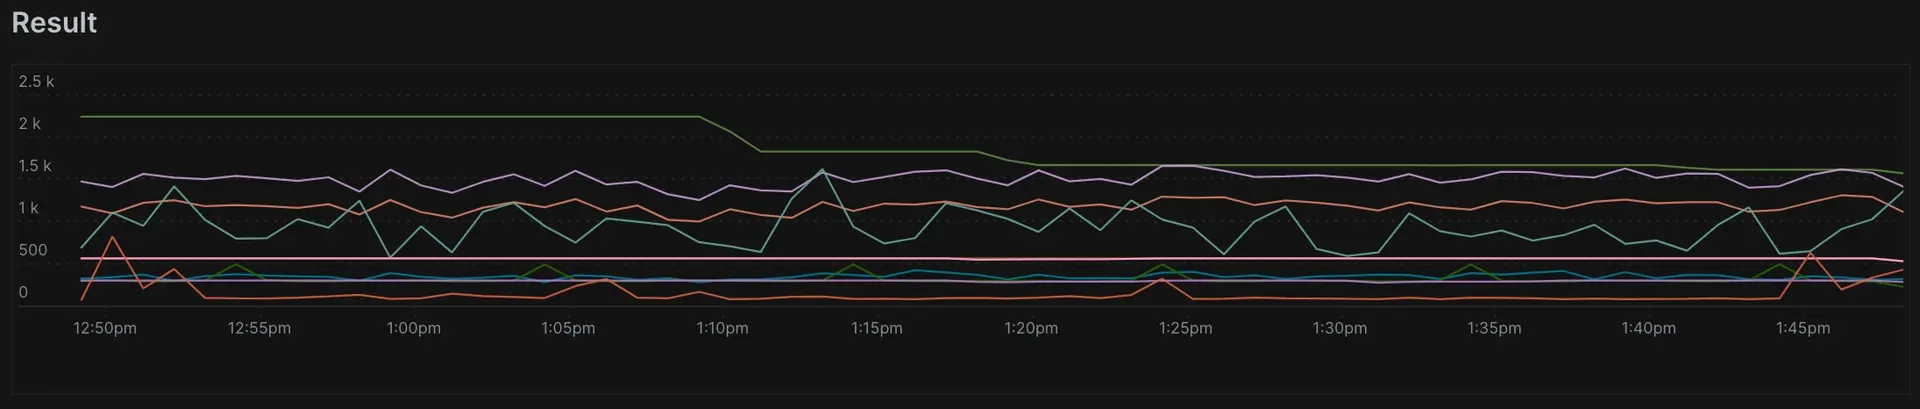
이렇게 하면 한계에 부딪힐 수도 있다고 생각할 수도 있습니다. 쿼리에서 EXTRAPOLATE 제거하고 개수가 변경되는지 확인하세요. 그렇지 않은 경우에는 한도에 도달하지 않았을 가능성이 높습니다.
쿼리에 EXTRAPOLATE 포함하면 보고된 이벤트와 전체 이벤트 간의 비율이 계산됩니다. 그런 다음 이 비율을 사용하여 샘플링되지 않은 데이터의 근사치를 추정합니다. 일부 쿼리에서만 이 사용을 지원한다는 점에 유의하세요. 이를 지원하지 않거나 샘플링된 데이터를 사용하지 않는 NRQL 쿼리에 포함되면 아무런 효과가 없습니다.
처리량과 같은 동종 데이터에서 EXTRAPOLATE 함수가 가장 유용합니다. 고유한 항목의 수(예: uniqueCount() 또는 uniques())를 외삽하려고 시도할 때는 효과적이지 않습니다. 따라서 EXTRAPOLATE은(는) 다음 집계자 함수 중 하나를 사용하는 NRQL 쿼리에서만 작동합니다:
apdexaveragecounthistogramsumpercentageratestddev
EXTRAPOLATE 이 완료되었으므로 패싯 케이스 사용으로 넘어갑니다.
패싯 케이스 사용
이전에 배운 것처럼, FACET은(는) 데이터를 분류하고 다르게 그룹화된 관점(예: 다른 응답 코드를 기반으로 평균 응답시간 확인)에서 데이터를 이해하는 데 도움이 됩니다. FACET을(를) 사용하면, NRDB는 제공된 속성 값을 기반으로 데이터를 그룹으로 구성합니다. 하지만 HTTP 응답 코드 200 및 201과 같이 다른 값을 함께 그룹화하려면 어떻게 해야 합니까?
FACET CASES() 패싯 버킷이 분할되는 방식을 선택할 수 있도록 하여 이 문제를 해결합니다. 연산자는 WHERE attr OP value 형식의 매개변수를 원하는 만큼 사용합니다. 아래 예에서는 "amazon", "google" 및 "microsoft"로 시작하는 http.url 이 포함된 모든 트랜잭션을 버킷으로 분류합니다. 또한 오류 응답 코드와 같은 작업을 통해 가독성을 높이고 애플리케이션에서 발생하는 상황을 이해하는 데 도움이 되는 방식으로 데이터를 그룹화할 수 있습니다.
SELECT count(*) FROM Public_APICall FACET CASES(WHERE http.url LIKE '%amazon%', WHERE http.url LIKE '%google%', WHERE http.url LIKE '%microsoft%')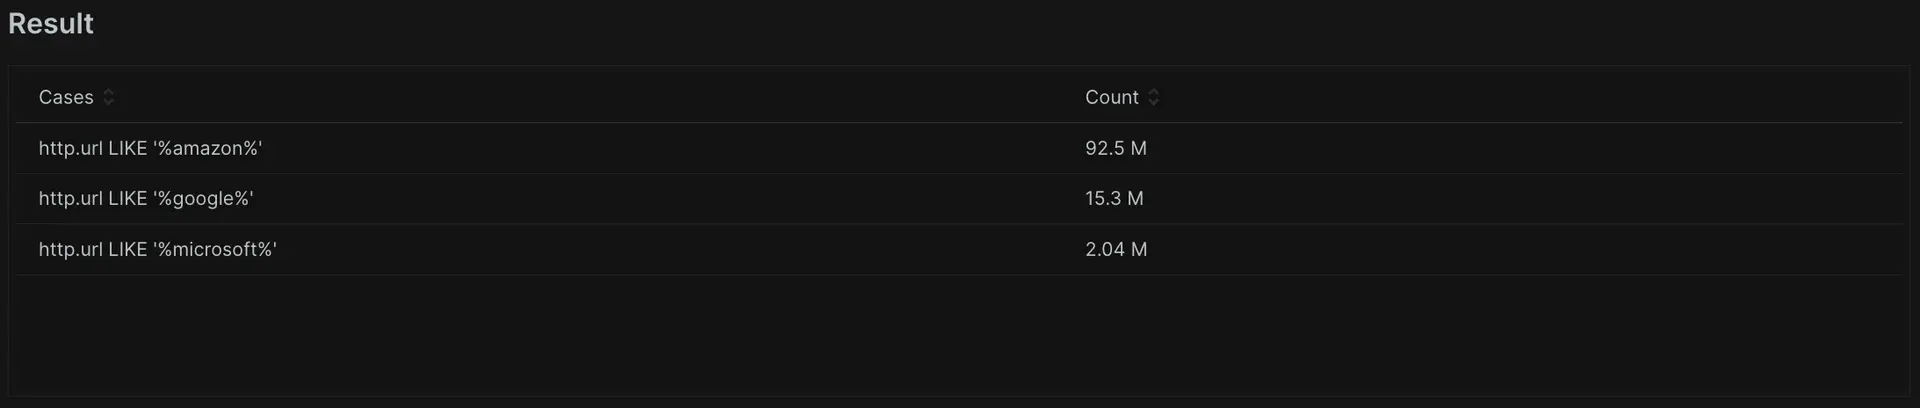
보시다시피 이러한 그룹화는 가치가 있지만 읽기 어려울 수 있습니다. 이전 튜토리얼에서 배운 내용을 사용하여 정리해 보겠습니다:
SELECT count(*) FROM Public_APICall FACET CASES(WHERE http.url LIKE '%amazon%' AS 'Amazon', WHERE http.url LIKE '%google%' AS 'Google', WHERE http.url LIKE '%microsoft%' AS 'Microsoft')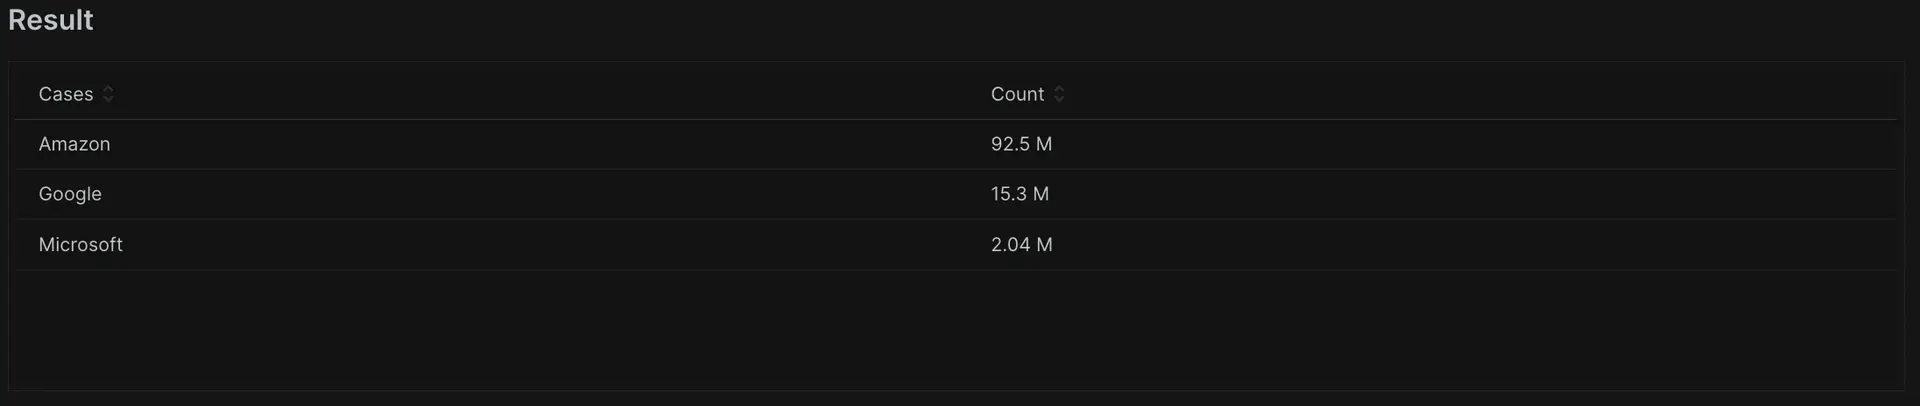
FACET CASES() 결합하려는 값이 다른 속성을 일치시키고 그룹화할 수 있습니다. 이 기능은 다양한 용도로 사용되며, 트랜잭션 데이터에 사용자 지정 데이터를 태그할 때 더욱 유용해집니다. 이를 통해 데이터를 탐색하고 그룹화할 때 더 많은 세분성과 제어력을 얻을 수 있습니다. 다음으로, 이번에는 이벤트 유형별로 필터링에 대해 자세히 살펴보겠습니다.
이벤트 유형별로 필터링
이제 뉴렐릭 고객 중에서도 아는 사람이 거의 없는 기능인 이벤트 유형 필터링에 대해 알아보겠습니다! 지금까지는 단일 소스에서 데이터를 가져오는 쿼리를 작성했습니다. 하지만 두 개의 다른 이벤트 유형으로 저장된 2개의 데이터 포인트를 플로팅하려면 어떻게 해야 할까요? NRDB 데이터를 쿼리할 때는 단일 이벤트 유형에 대한 제한이 없으며, 쉼표로 구분하여 여러 이벤트 유형에서 쿼리할 수 있습니다.
SELECT count(*) AS 'Combined Events' FROM NrdbQuery, NrDailyUsage SINCE 1 day ago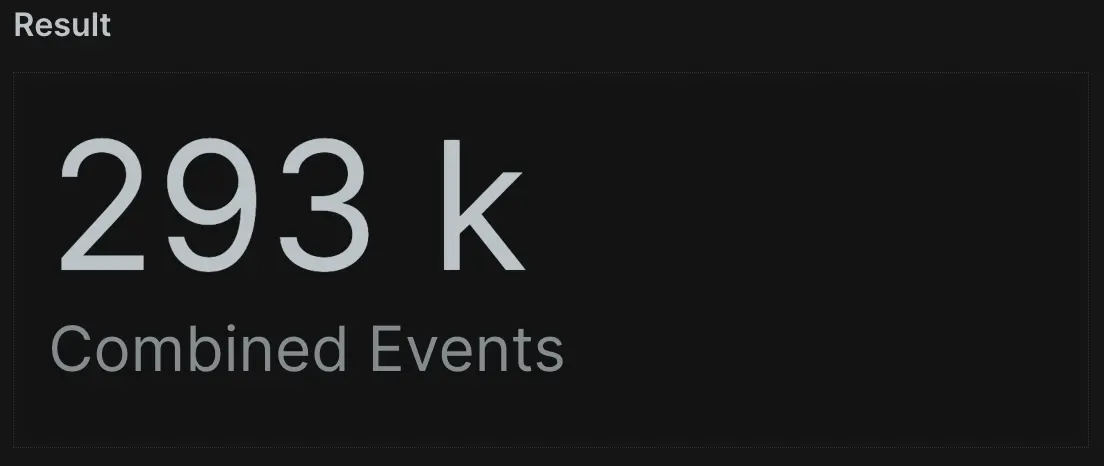
이를 더욱 유용하게 만들기 위해 eventType() 함수는 레코드가 어떤 이벤트 유형에서 나오는지 알려줍니다. 이를 사용하여 데이터 출력을 제어할 수 있습니다. 이 예에서는 결합된 Transaction 및 PageView 이벤트의 총 수는 물론 Transaction 및 PageView 의 총계만 볼 수 있습니다.
SELECT count(*) AS 'Combined Events', filter(count(*), WHERE eventType() = 'PageView') AS 'Page Views', filter(count(*), WHERE eventType()='Transaction') AS 'Transactions' FROM Transaction, PageView SINCE 1 day ago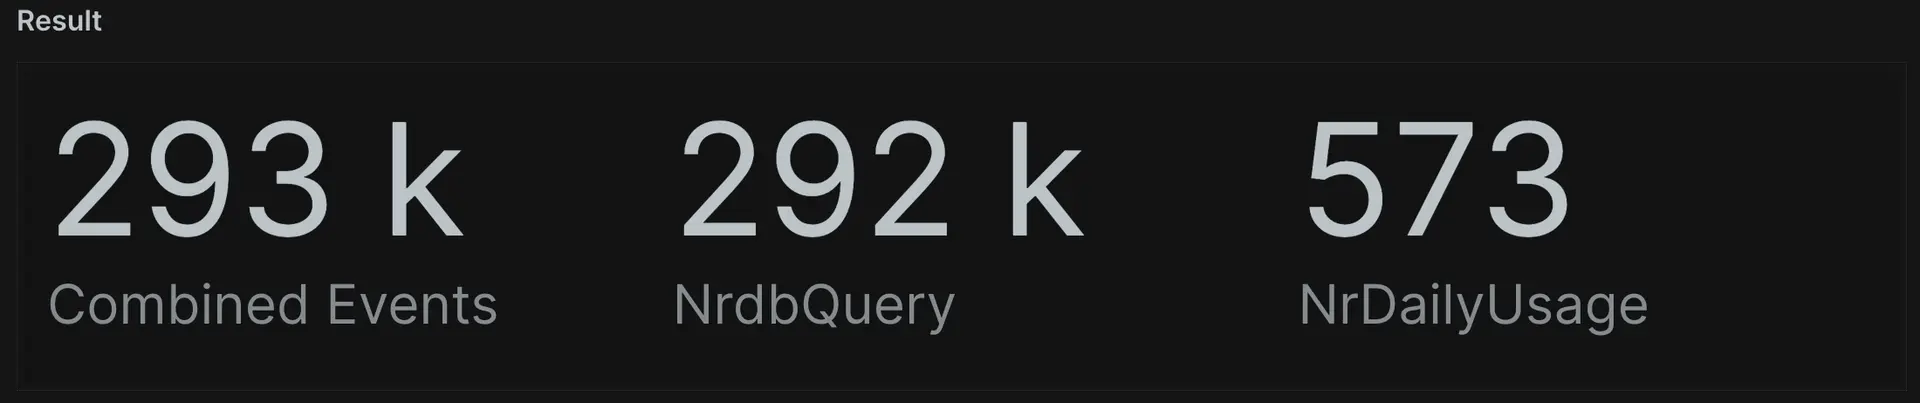
이를 더 자세히 살펴보겠습니다. count(*) Transaction 및 PageView 이벤트의 총 수를 표시합니다. 그러나 최근에 배운 집계 함수 filter() 를 사용하여 독특한 작업을 수행할 수 있습니다. 쿼리에는 필터 함수를 호출하여 전체 결과 집합의 일부로 이벤트 유형을 관찰하는 WHERE eventType()='PageView' 가 있습니다. 그런 다음 해당 특정 이벤트만 표시하도록 필터링합니다. TIMESERIES 추가하여 직접 비교할 수 있는 2개의 데이터 포인트를 선 그래프에 시각화할 수도 있습니다.
SELECT count(*) AS 'Combined Events', filter(count(*), WHERE eventType() = 'PageView') AS 'Page Views', filter(count(*), WHERE eventType()='Transaction') AS 'Transactions'FROM TransactionSINCE 1 day ago TIMESERIES max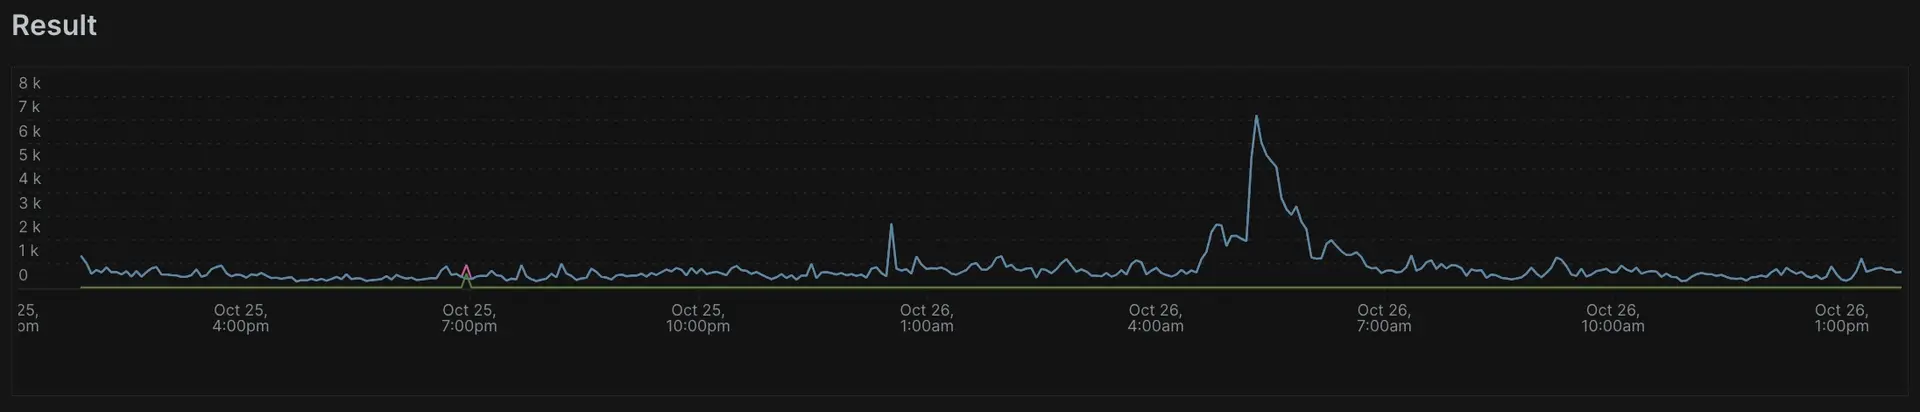
이제 두 가지 다른 이벤트 유형에서 데이터를 찾고, 반환하고, 그래프로 표시했습니다. 이 예제는 NRQL을 사용하여 필요한 데이터를 탐색하는 방법을 보여줍니다. 복잡한 조인 문이 필요하지 않습니다. 다음으로 재정의 값을 사용하는 방법을 알아보십시오.
값 재정의
NULL 값 계산
때로는 데이터가 필요한 형식으로 보고되지 않을 수 있습니다. 예를 들어, 수학 연산을 수행하기 위해 정수가 필요할 때 정수가 문자열로 반환될 수 있습니다. 또는 NULL 결과가 데이터에서 0을 나타낼 수 있습니다. NRQL은 이러한 경우를 처리하는 함수를 제공합니다.
NULL 속성 값은 기본 데이터와 사용자 정의 데이터 모두에 나타날 수 있습니다. count() 및 average() 같은 집계자를 사용하면 NRQL은 계산에서 NULL 값을 자동으로 제거하고 NULL 값이 없는 이벤트에서만 함수를 수행합니다. NRQL을 사용하면 OR value 절을 사용하여 계산에서 예상치 못한 NULL 값을 고려할 수 있습니다. 예를 들어, cartValue 속성의 NULL 값이 0으로 계산되도록 하려면 쿼리에 cartValue OR 0 사용할 수 있습니다.
이 예에서는 "http.url"에서 count() 를 실행합니다. "http.url" 횟수만 계산합니다. 가치가 있습니다. 그러나 쿼리에 OR 'Null' 추가하면 "http.url"이 포함된 모든 트랜잭션을 계산할 수 있습니다. 존재하며 이는 NULL 값이기도 합니다.
SELECT count(duration) AS 'Events With Durations', count(http.url OR 'Null') AS 'Events With and Without URL' FROM Public_APICall SINCE 1 day ago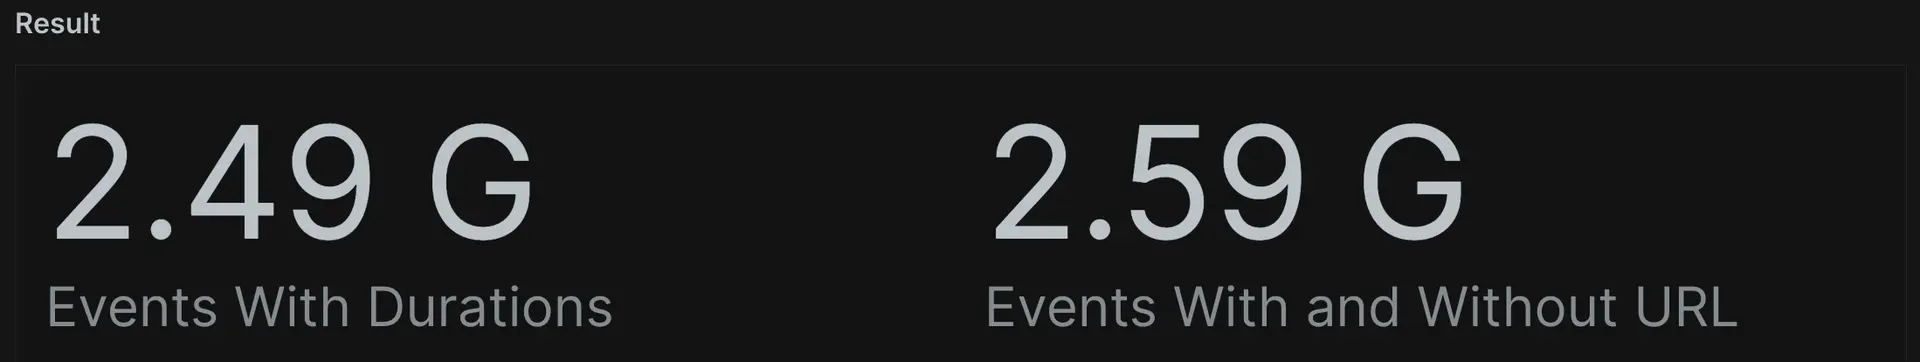
대시보드를 발전시키는 데 필요한 모든 것을 거의 배웠습니다! 다음으로 강제 변환을 사용하는 방법을 알아봅니다.
강제
NRQL은 강제를 자동으로 적용하지 않습니다. 이는 다른 문자열과 마찬가지로 문자열로 저장된 부동소수점을 처리하며 이를 sum() 또는 average() 같은 수학 함수와 함께 사용할 수 없음을 의미합니다. 이 동작을 재정의하려면 boolean() 또는 numeric() 사용하여 인수를 부울 또는 숫자 값으로 변환하세요. 이 예에서 "duration"에 대한 average() 함수는 이 속성이 문자열이므로 값을 제공하지 않습니다. 그러나 numeric(duration) 사용하여 속성을 숫자로 변환하면 average() 함수를 성공적으로 사용할 수 있습니다.
SELECT average(numeric(duration)) AS 'Ensuring stored value is treated as numeric', average(duration) AS 'Non-Converted Attribute' FROM Public_APICall SINCE 1 day ago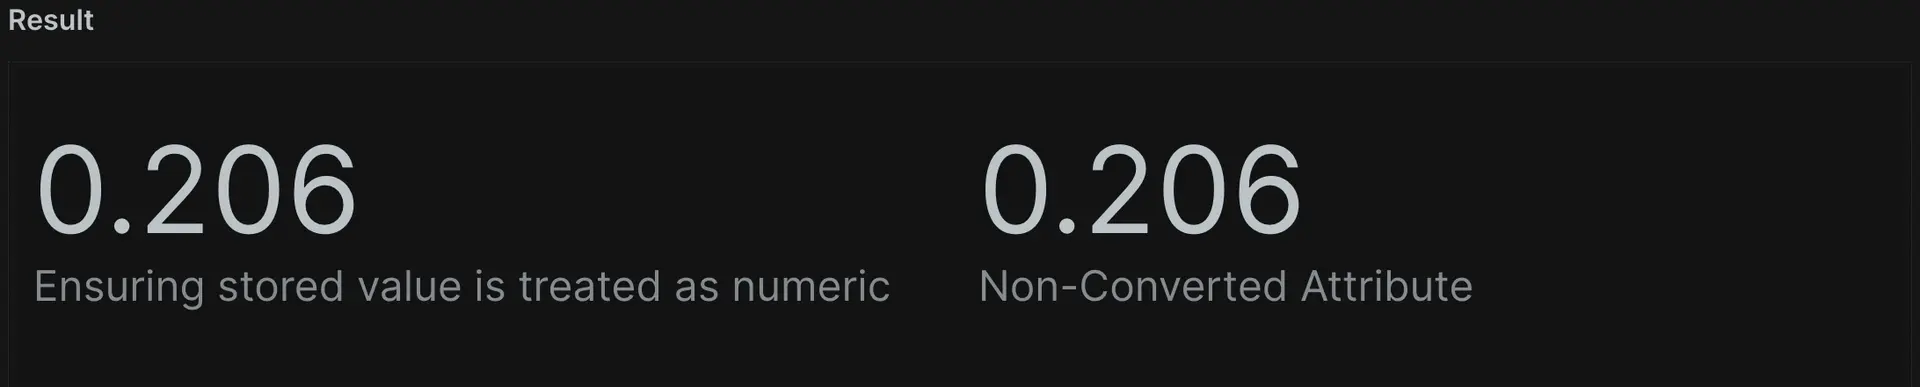
또 다른 일반적인 예는 종종 문자열로 잘못 형식화되는 BOOLEAN (TRUE 또는 FALSE) 값입니다. 이 경우 소스가 데이터를 전송하는 방식을 변경하여 적절한 부울로 만들 수 있습니다. 또는 boolean() 함수를 사용할 수 있습니다. 아래의 예제 쿼리는 동일한 결과를 반환하지만, 이는 에이전트가 BOOLEAN(으)로 전송하는 값을 사용하기 때문입니다. 속성이 문자열 "TRUE"인 경우, boolean()은(는) 이를 적절한 부울 형식으로 변환하여 쿼리가 의도한 대로 실행되도록 합니다.
SELECT count(boolean(sampleDataSet)), count(sampleDataSet) FROM Public_APICall SINCE 24 hours ago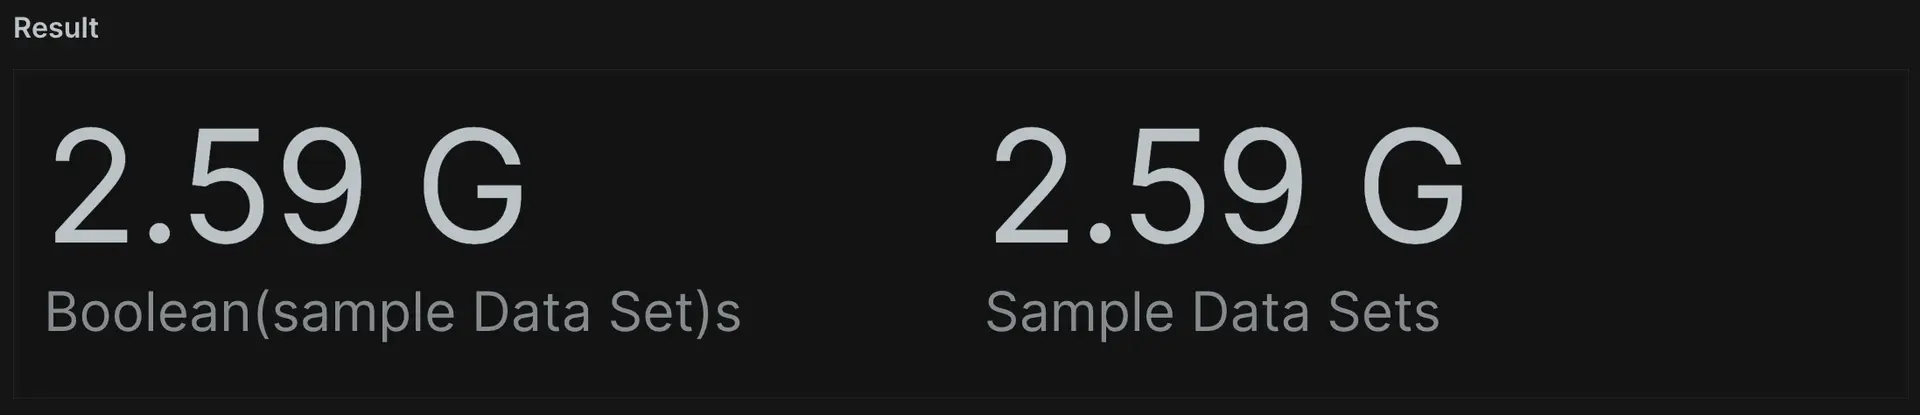
string() 함수를 사용하여 부울 및 숫자 값을 문자열로 변환할 수도 있습니다. 숫자 값을 부동 소수점 숫자로 사용하면 선택적 precision 인수를 사용하여 문자열의 소수 자릿수를 제한할 수 있습니다. 이 쿼리는 기간 값을 소수점 세 자리로 제한된 문자열로 반환합니다.
SELECT string(duration, precision: 3) FROM Public_APICall SINCE 24 hours ago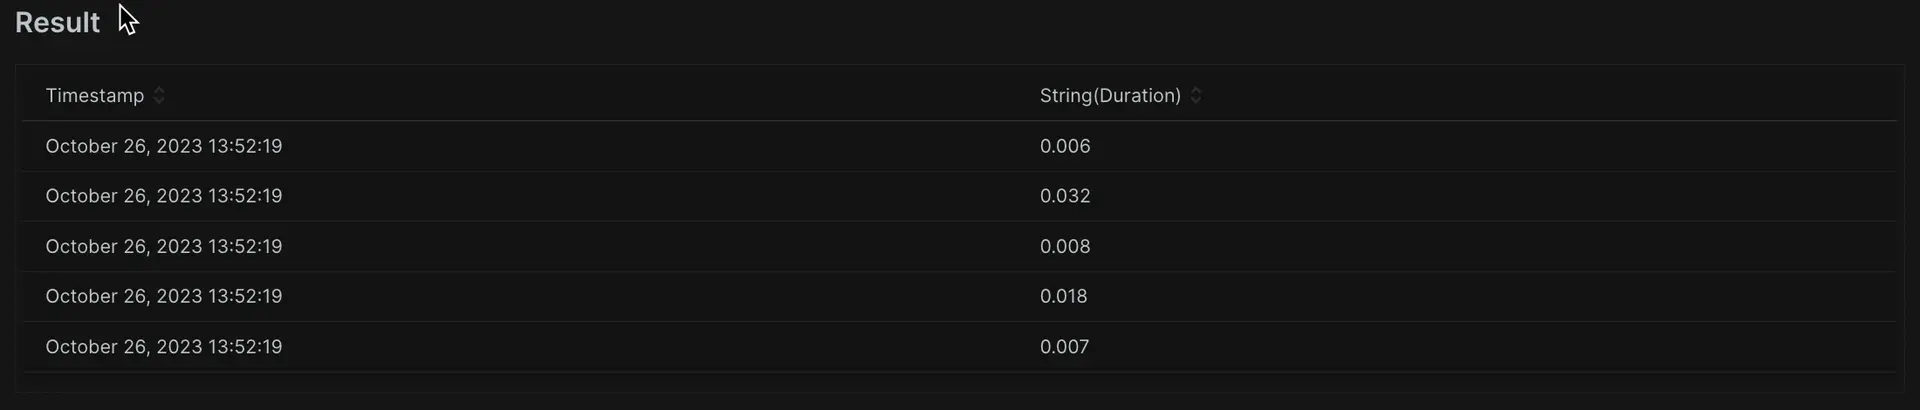
이제 데이터 형식을 제어하고 NRQL이 어떻게 작동하기를 원하는지 지정할 수 있습니다. NRQL은 가장 논리적이라고 판단되는 방식으로 작동하지만, 고유한 시나리오에 맞지 않는 경우 이 단원에서 살펴본 함수를 사용하여 해당 값을 재정의할 수 있습니다. 이제 배워야 할 것은 문자열 연결뿐입니다.
문자열 연결을 사용하여 인수 추가
속성의 반환된 값에 텍스트를 추가하거나 앞에 추가해야 하는 경우가 있을 수 있습니다. concat() 함수를 사용하여 이를 달성할 수 있습니다. concat() 함수에 최대 20개의 인수를 제공하여 문자열로 연결할 수 있습니다.
SELECT concat('The duration of ', http.url, ' is ', duration, ' seconds') FROM Public_APICall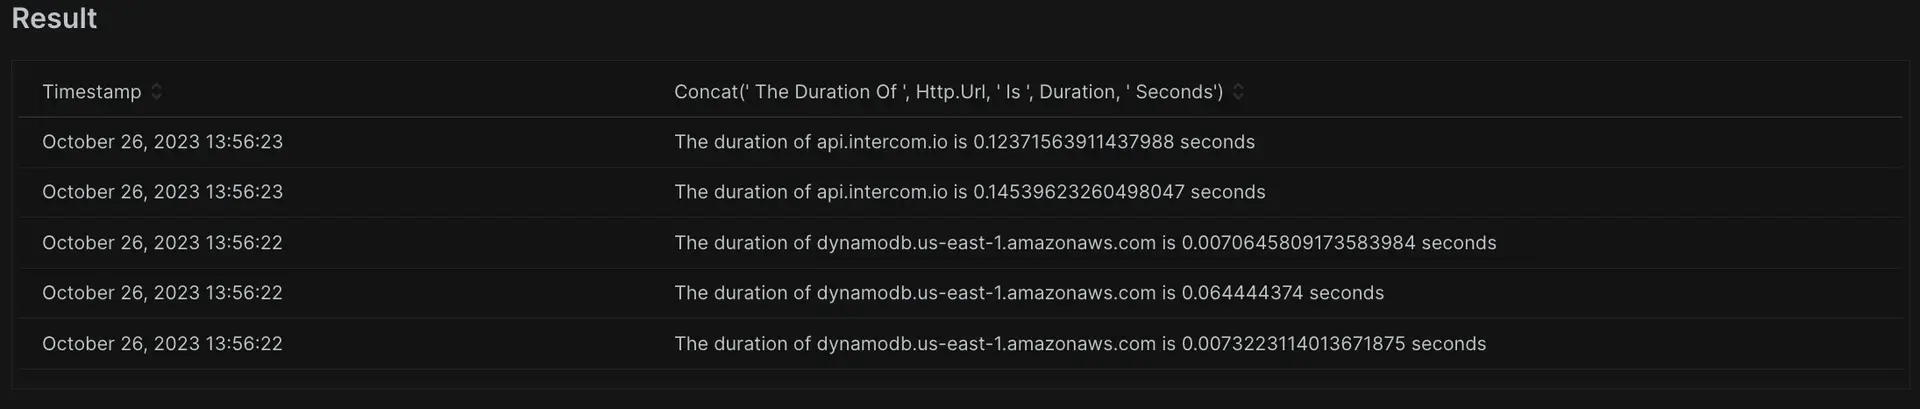
연결된 속성 값의 부동 소수점 숫자에 사용하는 소수 자릿수를 제한할 수 있습니다. 이렇게 하려면 선택적 precision: 인수를 마지막 값으로 사용합니다. 이 예에서는 초를 표시하기 위해 's'를 추가하고 값을 소수점 3자리로 제한합니다.
SELECT http.url, concat(duration, 's', precision: 3) FROM Public_APICall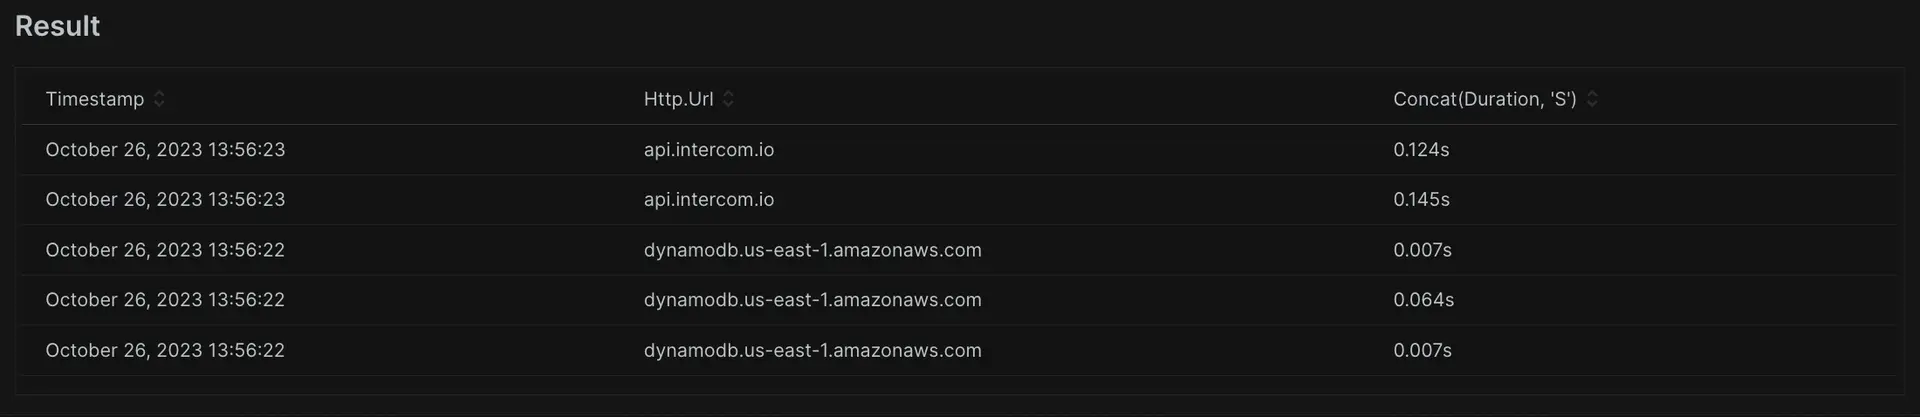
뉴렐릭은 http(s) (으)로 시작하는 값을 클릭하여 새 페이지를 열 수 있는 링크로 자동으로 표시합니다. 즉, 동적 URL이 엔티티와 관련된 페이지를 열 수 있는 솔루션에 대한 통합을 생성할 수 있습니다. 다음 예는 속성 값으로 쿼리 파라미터 값을 설정하는 예제 URL을 보여줍니다.
SELECT http.url, concat('https://www.example.com/?appId=', api, '&error=', error) AS 'URL' FROM Public_APICall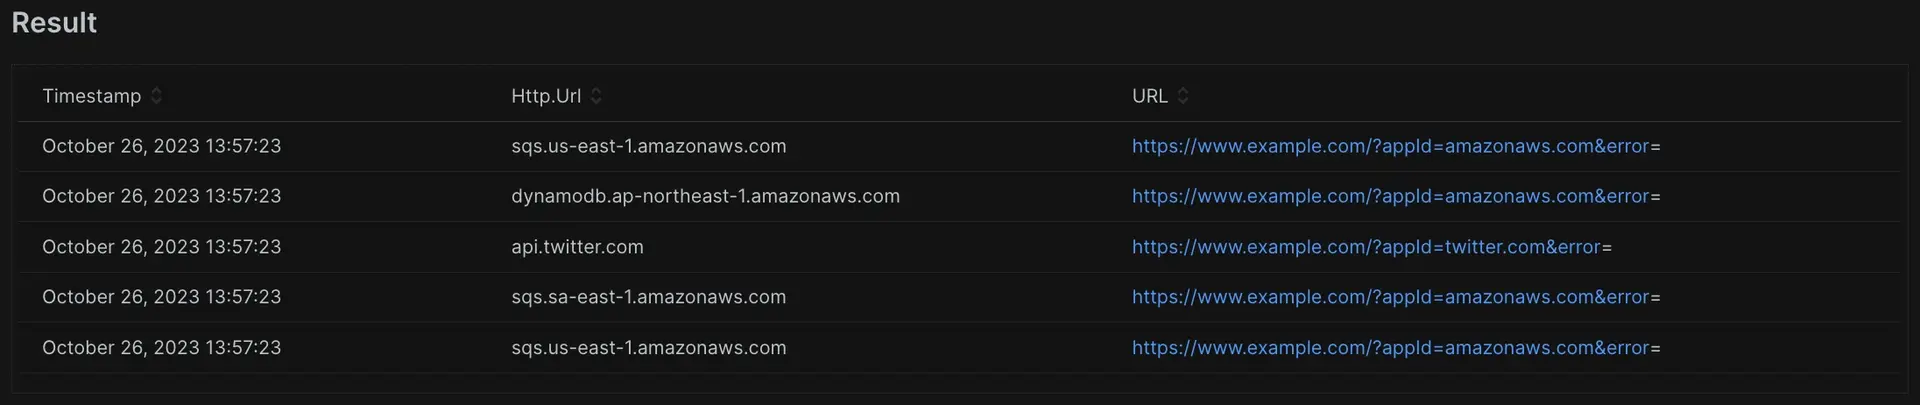
concat() 함수를 사용하면 위치에 대한 도시 및 국가와 같은 값을 함께 결합하고 추가 문자열을 앞에 추가하거나 추가하여 필요에 따라 데이터를 표시할 수 있습니다.
이 튜토리얼에서는 고급 NRQL 기능을 살펴보았습니다. 이러한 기술은 많은 실제 NRQL 시나리오에 적용됩니다.
이제 세 번째 NRQL 튜토리얼을 완료했습니다. 준비가 되면 이 시리즈의 다음이자 마지막 튜토리얼에서 더 고급 기능을 다룹니다: NRQL 고급 기능.